



玄览:八套术数,放进同一张桌子

假设你现在真的有件事拿不定主意——要不要换工作。
你找了三种方式问:八字说今年流年不利、宜守;塔罗抽出来是战车正位、宜进;奇门排盘说时机未到。三套说法互相打架,你该信谁?
大多数人的处理方式是:信自己本来就想信的那个。所谓的”参考”,其实是在给自己已经做好的决定找一句背书。
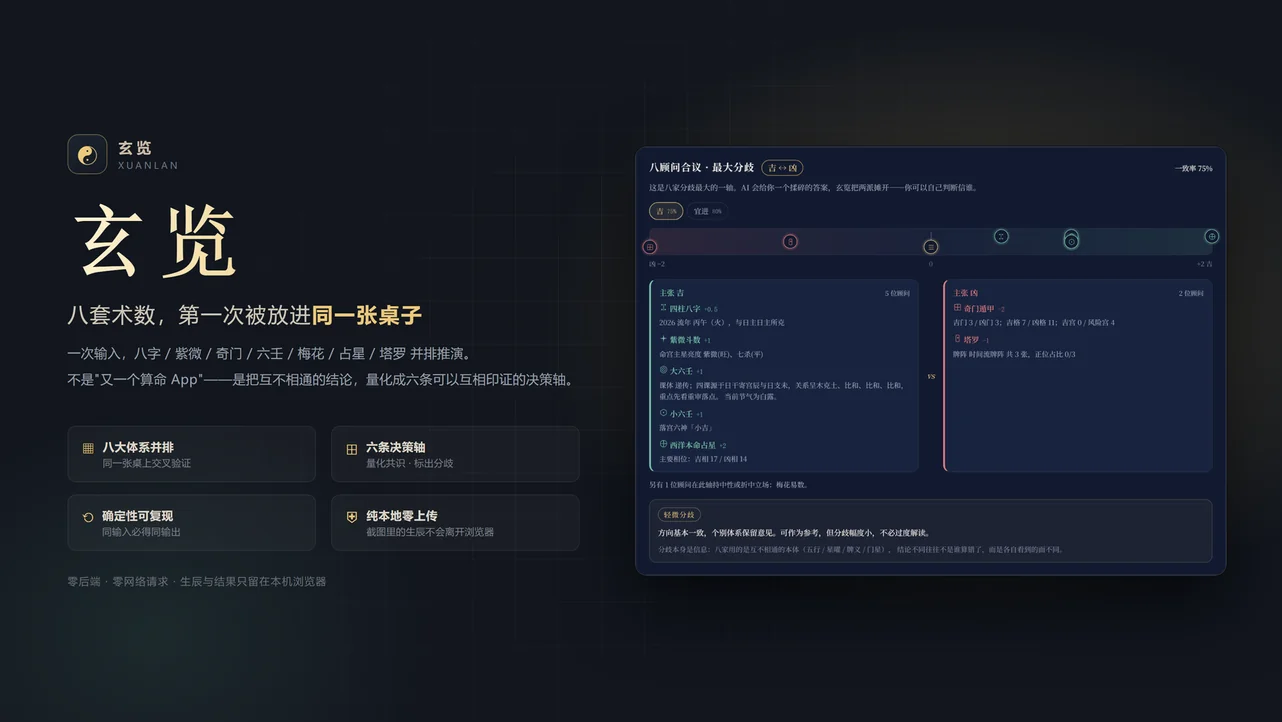
我做的”玄览”,想解决的是这个环节:它把八套体系放进同一次推演,然后量化地回答三个问题——它们结论一致吗?一致到什么程度?谁在唱反调?
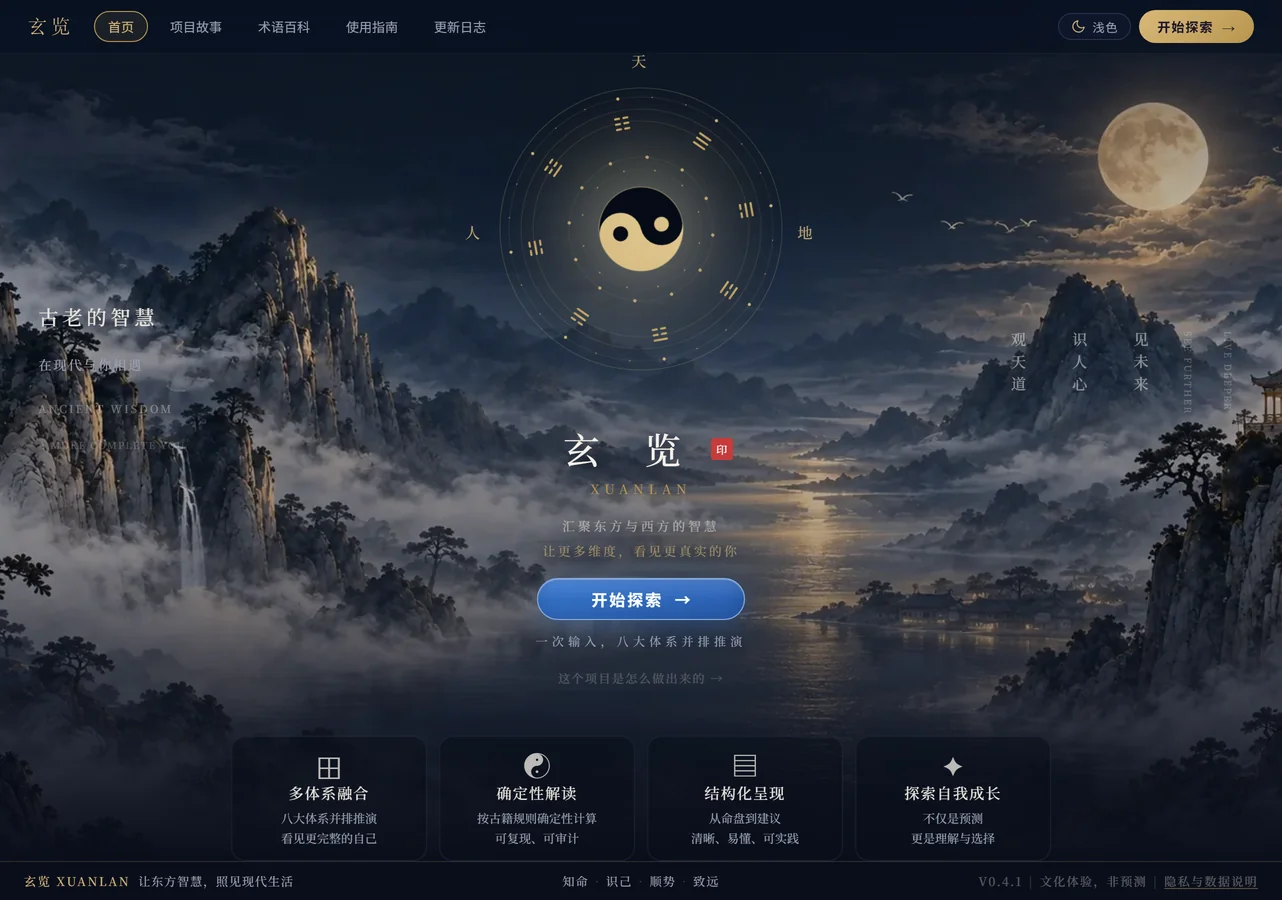
这篇介绍它能做什么、怎么用,以及几个功能背后的实现思路。
01 · 它和「直接问 AI」的区别
先把这件事说清楚,因为它决定了这个项目的全部设计。
把同一份生辰和同一个问题丢给大模型,它会给你一段很流畅、很有底气的解读。问题不在于它说得不好,而在于你没有办法验证它:
- 同一个问题问两次,可能得到两个答案;
- 它引用的”古籍原文”,有一部分是编的;
- 它不会主动告诉你”我这一套和那一套看法相反”——它会把冲突悄悄抹平,给你一段自洽的叙事。
玄览走的是另一条路。同样的输入,它给你四样东西:
| 直接问 AI | 玄览 | |
|---|---|---|
| 结果形态 | 一段不可验证的话 | 八套按古籍规则确定性计算的盘 |
| 稳定性 | 同问两次可能不同答 | 同一输入必得同一输出 |
| 多体系关系 | 揉成一段自洽叙述 | 量化共识 + 显式标出分歧 |
| 数据流向 | 你的生辰上传到服务器 | 零网络请求,全在浏览器本地 |
这里要立刻补一句:它不是预测,也不宣称准确。它做的是”把八套体系的结论摆到同一张桌上,让你看见它们分歧在哪”,而不是”告诉你未来会怎样”。这条边界从产品第一版就写在首屏,后面还会反复出现。
02 · 最难的一步:让八套体系可以互相比较
八套体系的术语体系完全不通用:
- 八字讲五行生克、日主旺衰;
- 紫微讲星辰宫位、四化飞星;
- 奇门讲九宫格局、方位吉凶;
- 塔罗讲牌义与牌阵位置。
“八字身强,喜金水”和”塔罗抽到战车正位”,这两句话没法直接比较——它们连本体都不在一个层面上。
强行统一是不可能的,也没必要。玄览的做法是不碰它们的本体,只统一输出口:让每个体系用自己的原生语言判断,但对外只输出六个维度上的倾向值。
| 决策轴 | 两极 |
|---|---|
| 行动 | 宜动 ↔ 宜静 |
| 时机 | 宜进 ↔ 宜守 |
| 人际 | 结盟 ↔ 独处 |
| 进取 | 进取 ↔ 避险 |
| 变化 | 求变 ↔ 守常 |
| 吉凶 | 吉 ↔ 凶 |
每条轴的取值落在 [-2, +2],并带一个置信度权重。
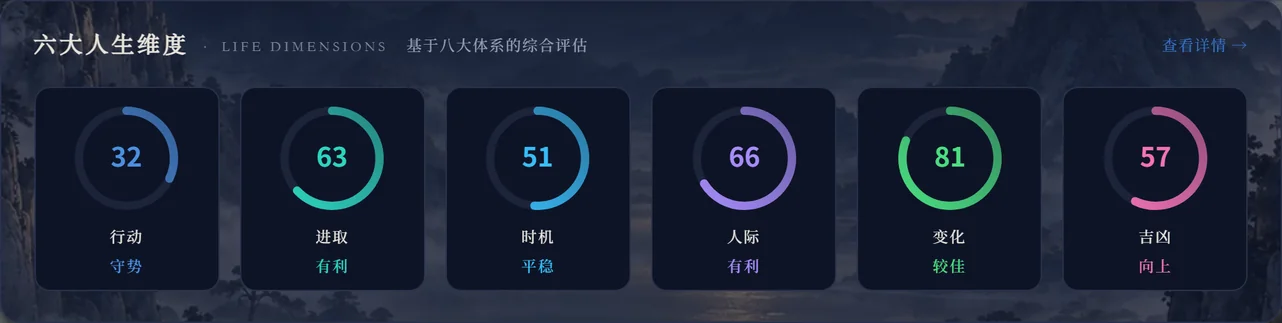
这是整个项目最值钱的一个建模决策。本质上它是”异质多专家系统”的收敛做法——多位专家用各自的语言给判断,但要比较他们,就必须先定义一套共同的问题空间。
投影一旦完成,“八字身强喜金水”和”塔罗战车正位”就第一次可以放在同一张表里了:前者落在”行动 + 时机”的正向,后者落在”进取 + 变化”的正向。它们不是同一种语言,但回答了同一组问题。
03 · 共识不是平均分
有了六条轴上的数值,聚合层做三件事:
- 加权平均(按各体系的置信度)→ 得到每条轴的主调;
- 一致率(同方向体系占比)→ 得到”它们有多齐心”;
- 分歧体系(
|得分 − 均值| > 1)→ 得到”谁在唱反调”。
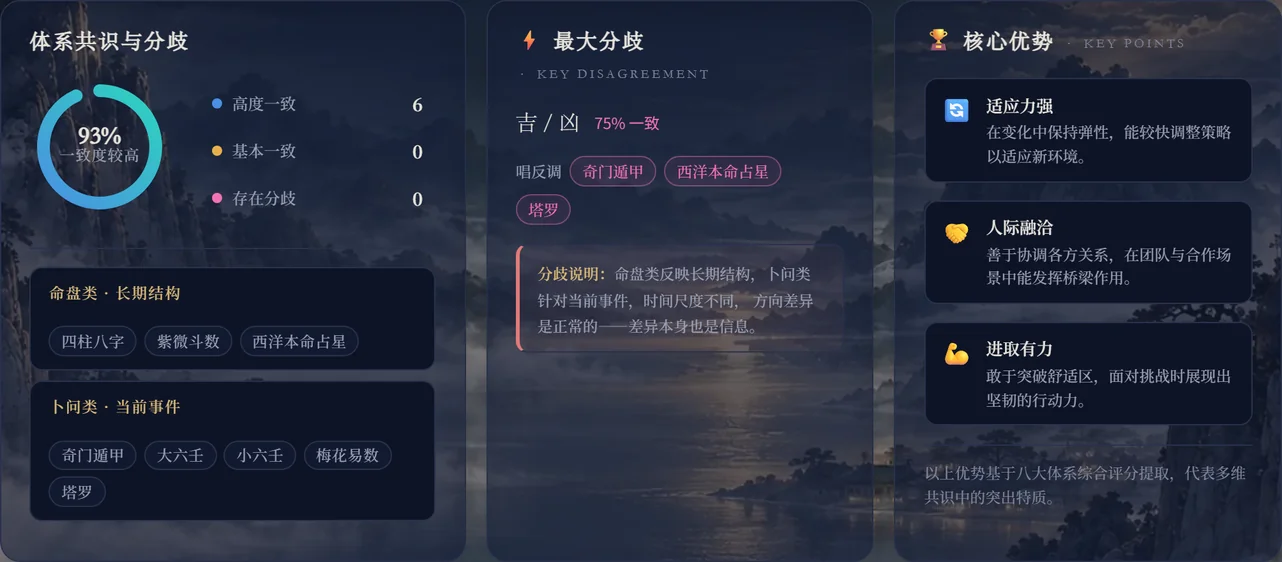
这里有一个必须说清楚的陷阱,我把它印在了每处结论旁边:
一致率高不等于结论准。 共识度衡量的是”体系之间一致不一致”,不是”这件事发生的概率”。
八套体系用的本体互不相通,它们一致,只说明它们在这次判断里看到了同一种信号;它们不一致,也不说明谁算错了。把一致率读成”准确率”,是这类工具最容易产生的误解——所以我宁可让这句话在每个结论旁重复出现。
04 · 分歧本身就是信息
这是我最想讲的一个设计,也是我认为它和”AI 直接回答”最本质的分野。
大模型会把八家意见揉成一段自信的整合叙事。玄览反着来:它偏要把分歧演给你看。
系统自动挑出分歧最大的那一条轴,把”主张动/吉”和”主张静/凶”两派各自摊开,附上每家的原始判词:
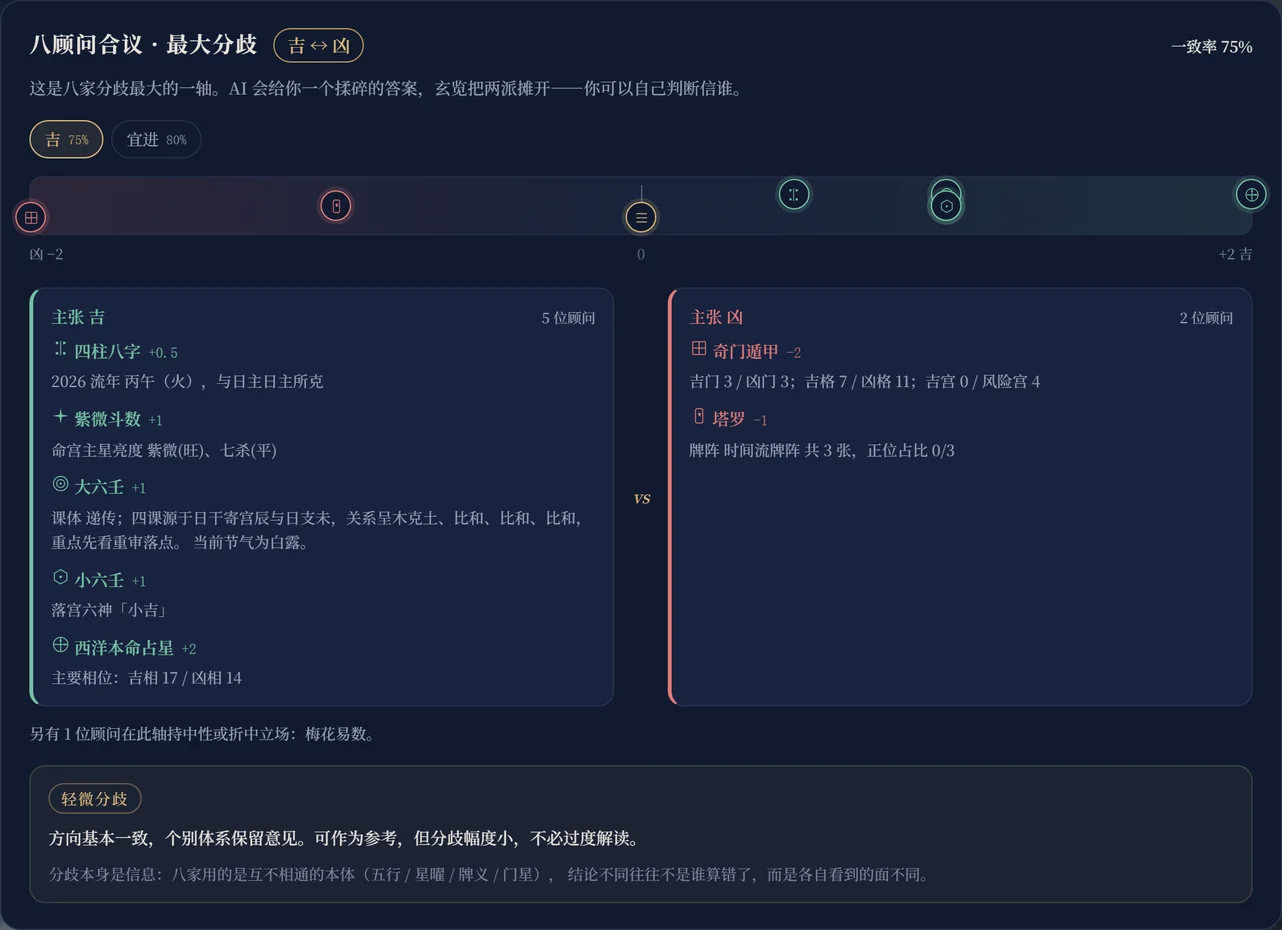
上面这张图里,吉↔凶这一轴只有 75% 一致:五家主张吉、两家主张凶、一家持中性。左栏是四柱八字、紫微斗数、大六壬、小六壬、西洋占星各自的判词;右栏是奇门遁甲与塔罗。
这个视图的价值不在于”哪边对”,而在于:当你看到分歧的具体内容时,你才知道自己之前忽略了什么角度。
分歧说明里也写清了它可能的来源——命盘类反映长期结构,卜问类针对当下事件,两者时间尺度不同,方向出现差异是正常的。换句话说,一个看起来矛盾的结果,本身可能就是它最诚实的地方。
05 · 一条链接,对方打开逐字一致
这一节讲工程上我最看重的一条约束:可复现。
内核是纯函数:禁 IO、禁 Date.now()、禁 Math.random()。时间由调用方注入,卜卦类体系的”随机种子”也不是真随机——它由 问题文本 + 主题 + 问事时刻 哈希派生,可溯源。
这条约束带来一个很实用的能力:只读分享链接。链接里只装输入(生辰、所问、种子),对方浏览器用同一套内核重算,得到的是逐字一致的结果——不需要任何服务器。
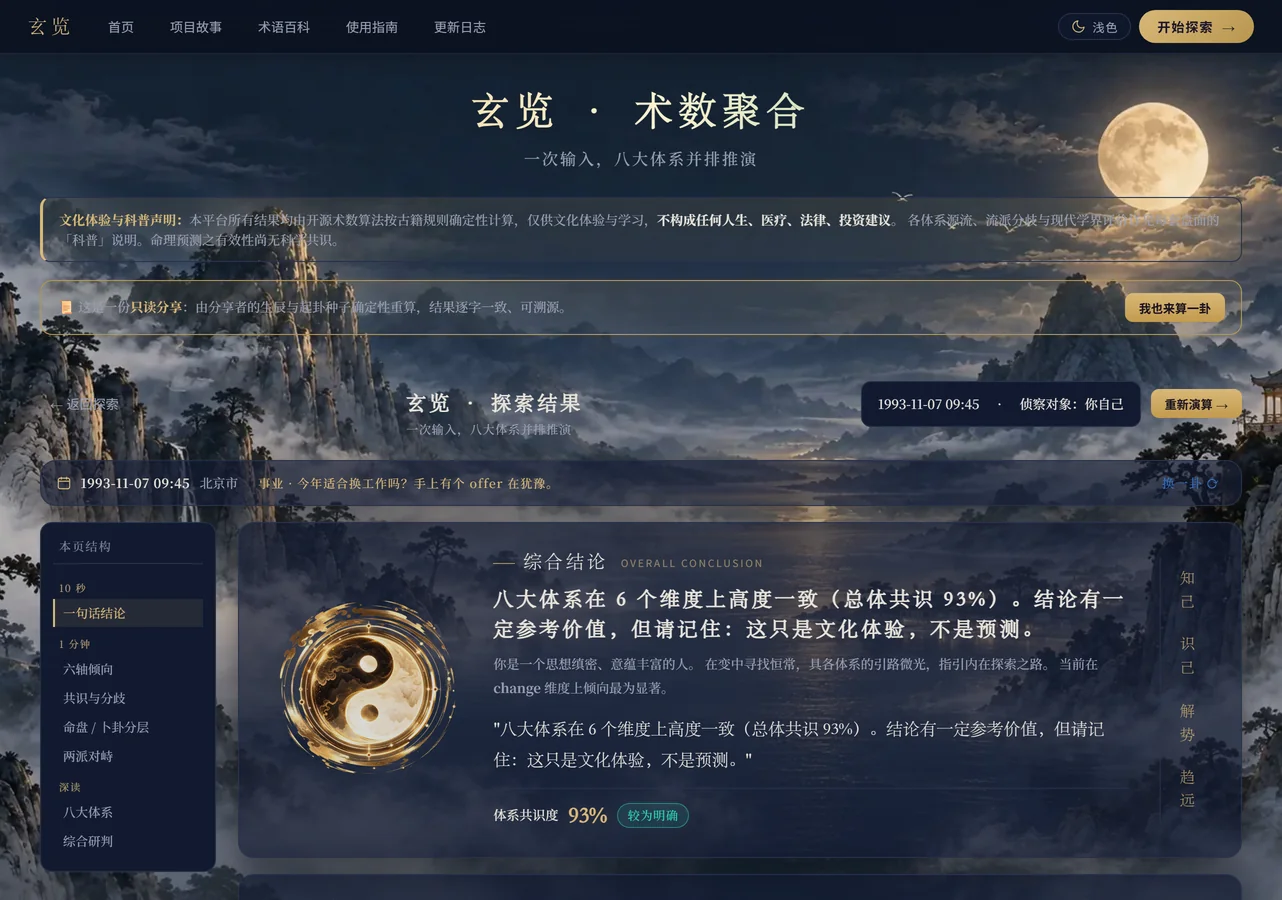
写这篇文章时我顺手做了个验证。为了截图,我需要一份每次打开都完全一样的结果(否则文章里的百分比和配图对不上),于是我在 Node 里复现了同一条种子派生算法,手工构造出一条分享链接。
然后用它分别打开桌面浏览器和手机模拟器:
桌面端 六大维度:32 / 63 / 51 / 66 / 81 / 57手机端 六大维度:32 / 63 / 51 / 66 / 81 / 57逐个相同。这不是”看起来差不多”,是同一份输入下的同一份输出——而且跨设备、跨渲染引擎。
这个性质在别处也有用。历史记录里存的是完整结果而不是种子:算法以后肯定会改,如果只存种子,老记录重算之后就会变形,而你当时看到的那一屏就永远找不回来了。
06 · 内核严肃,外壳科普
一个算命类产品最容易被诟病的地方是”为了准的观感而夸大”。所以在算法层之外,这个项目花了很大力气在做相反的事:把做不到的部分标出来。
最典型的是子时换日问题。23:00–01:00 出生的人,日柱按”早子时”还是”晚子时”处理,不同流派口径不同,算出来可能差一位。这不是 bug,是流派分歧——所以它没有藏起来,而是直接写在盘面上:
早晚期子时换日:23:00–01:00 出生,日柱可能相差一位(已实测:2000-12-31 23:59 广州)
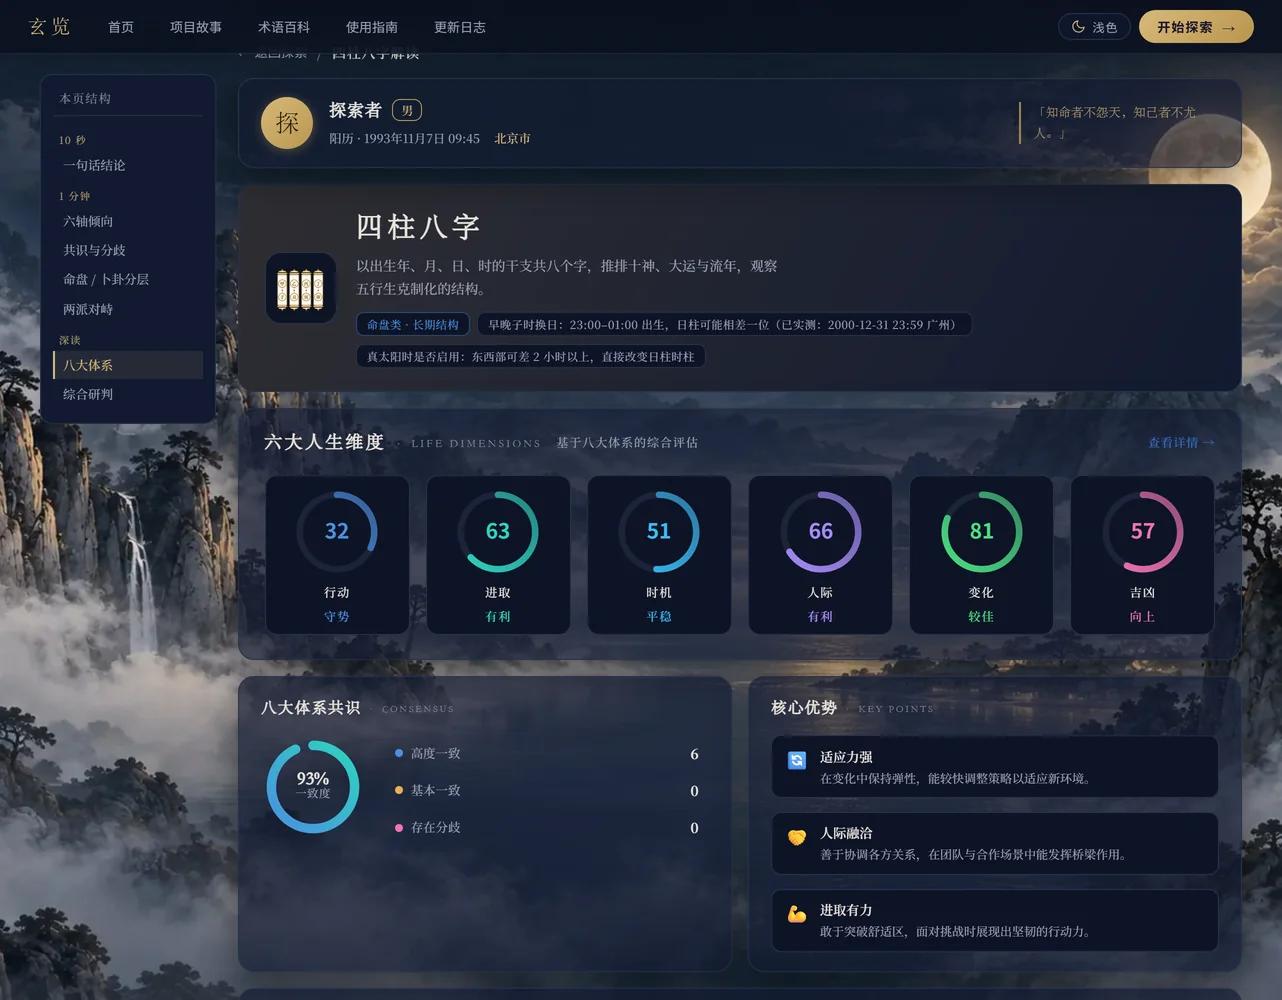
同样被明确标注的还有一批底层能力的硬边界:星盘分宫制只支持 Placidus 且不可切换、紫微的四化飞星与自化底层不支持、梅花易数只开放时间卦。这些在界面上置灰并说明原因,而不是让你点了之后得到一个似是而非的结果。
我一直觉得这是这个项目设计上最加分的一处:产品经理最难的不是加功能,是克制地标注”这个我做不到”。
07 · 把结果翻译成人话,而且不靠 AI
八套体系算出来的是一堆术语。把它们翻译成能读的长文,是这个项目的”解释层”做的事:
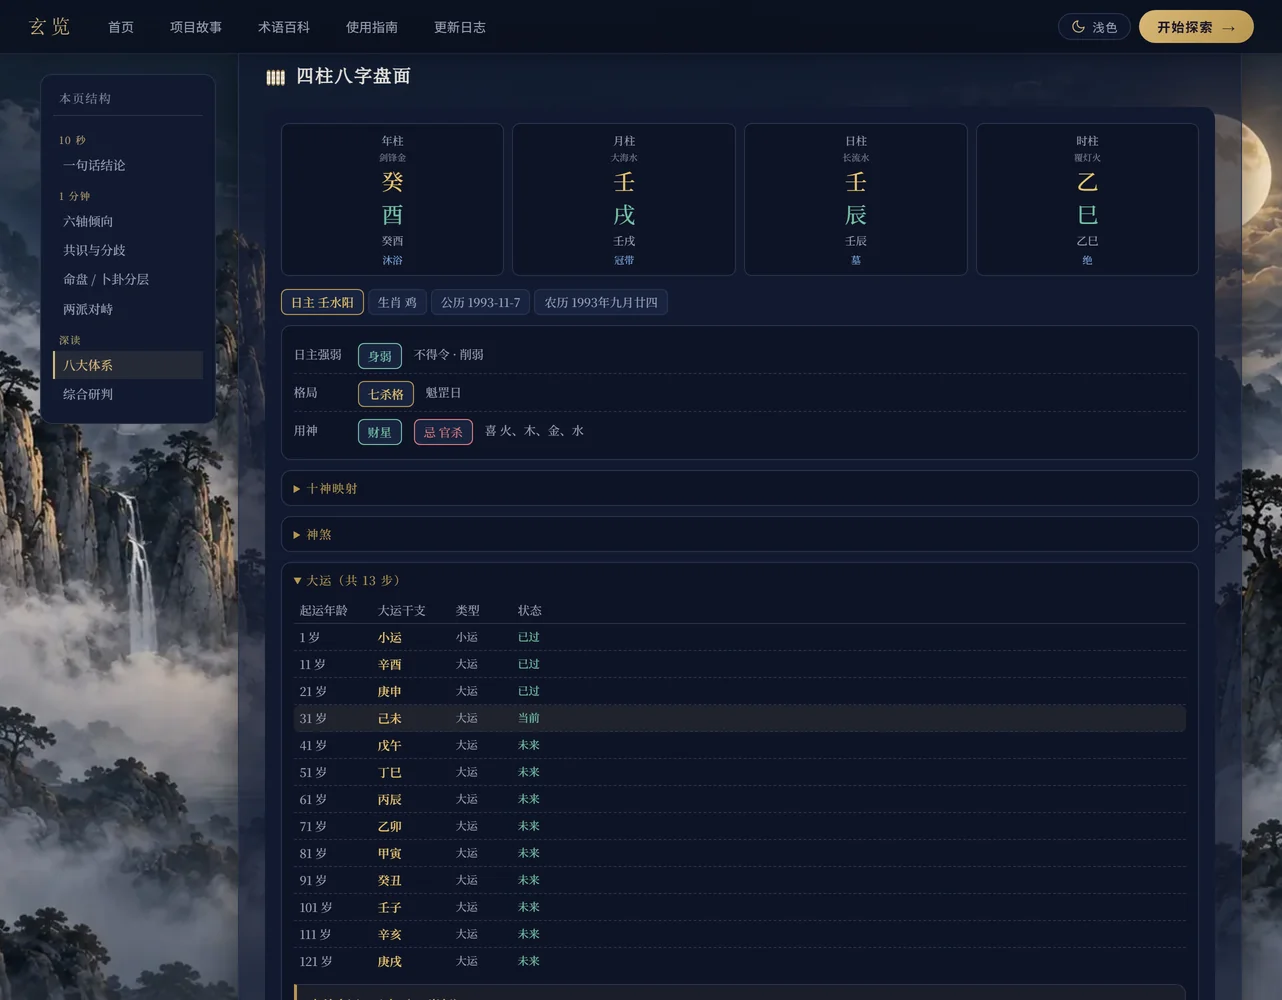
这一层是模板化叙事,零随机、零 AI。原因和判定层一致:可复现是硬约束。同一个输入,今天和明年给出的报告必须能逐字对上——只有确定性生成做得到。
顺便讲一件写这篇文章时撞见的事。
我在核对首页文案时发现,入场页的功能点里写着一句「AI 深度解读 · 结合古典智慧与现代算法,提供个性化分析」。而这个项目的代码里:没有任何网络请求,没有任何模型调用,综合解读报告是确定性模板生成的。
这是早期文案的残留,和项目自己反复强调的”AI 绝不参与计算”直接冲突——而且冲突的地方偏偏是这个项目最看重的那件事。我把它改成了:
确定性解读 · 按古籍规则确定性计算 / 可复现、可审计
这件事给我一个提醒:一个项目的”诚实”不是写在 README 里的,是要能被代码验证的。README 里写着”零 AI”,首页却拿 AI 当卖点,读者一旦发现,前面建立的所有信任都会反过来变成负分。
08 · 首屏的瓶颈不是那 1.2MB 内核
这一节讲性能,因为排查过程比结论更有意思。
直觉上,这个项目的首屏应该被算法内核拖累——它确实很大:
core chunk 1,241.62 kB (gzip 481.92 kB)CSS 144.78 kB (gzip 27.90 kB)但实测下来,拖住首屏的根本不是它。真正卡着的是 Google Fonts 的样式表:单个文件 181KB(gzip),并且是渲染阻塞资源——它没下完,浏览器就不许画任何东西。
改成非阻塞加载之后,FCP 从 2064ms 降到 872ms。
接着是第二件事:一张 148KB 的山水背景图。它已经被标成 Low 优先级了,但仍然占着管道,把字体样式表的完成时间从 1.73s 拖到 2.47s;把它拦掉,从首绘到 LCP 的空档从 2452ms 降到 1504ms。
两个看起来显然的优化,实测被否掉了:
- 把大图延后到首绘之后再加载 —— 结果它被排到了字体队列的尾部,山水出现的时刻反而从 2.6s 变成 8.7~10.2s。教训是判据不能只看 LCP,还要同时量”被延后的那个资源自己什么时候到”。
- 用
display=optional让字体不阻塞 —— 无效。它只是不 swap,不是不下载;Chrome 对文本的 LCP 会一直压到字体有结论为止。
还有一个更值得记的坑:工具自己会骗人。
性能瀑布原先的逻辑是”等网络安静下来再快照”,于是 A/B 两个方案是在不同长度的窗口里统计的——同一个站点,能报出 477KB 和 1876KB 两个”首屏体积”,看着像省了 4 倍。现在窗口固定,数字才可复现。
同类的事在做死代码清理时又出现一次:浏览器覆盖率报告”未匹配 41.1KB(29.1%)“,但静态分析只能证明其中 18.1KB 是真死。别把”未匹配”当成”可删”——两者的差集是”类名还活着,只是这次没走到那个状态”。
图片这条线相对直接:全站 5.55MB → 859KB(省 84.9%),太极图、八体系图标与两幅山水背景全部改成 WebP。
09 · 它现在是什么,还不是什么
目前的状态:八大体系、六条决策轴,内核 49 项 + 前端 51 项测试(含黄金样本、对拍、边界、确定性回放)。
边界也要说清楚,而且这些不是免责套话,是真的使用限制:
- 有效性在科学上尚无共识。 这是最根本的一条——它输出的是按古籍规则做的确定性计算,不是概率预测。
- 共识度不是预测概率。 它衡量体系之间的一致性,见上文第 03 节。
- 命盘类与卜问类不能混谈。 八字、紫微、西洋占星由出生信息决定,反映长期趋势,不随你此刻的问题改变;六壬、奇门、梅花、小六壬、塔罗针对此问此刻,换时间、换问题,卦象自然不同。把两者放在一起比”哪个准”没有意义。
- 底层算法有硬边界。 分宫制只支持 Placidus、紫微四化飞星不支持、梅花只开放时间卦——都在界面上置灰说明。
- 排盘能力依托两个开源库(iztro 与 mingyu-core),项目本身补的是多体系聚合、决策轴建模、共识与分歧聚合、解释层与可复现分享这些部分。
- 它不是给决定背书的东西。 涉及人生、医疗、法律、财务的决定,请咨询持证专业人士。
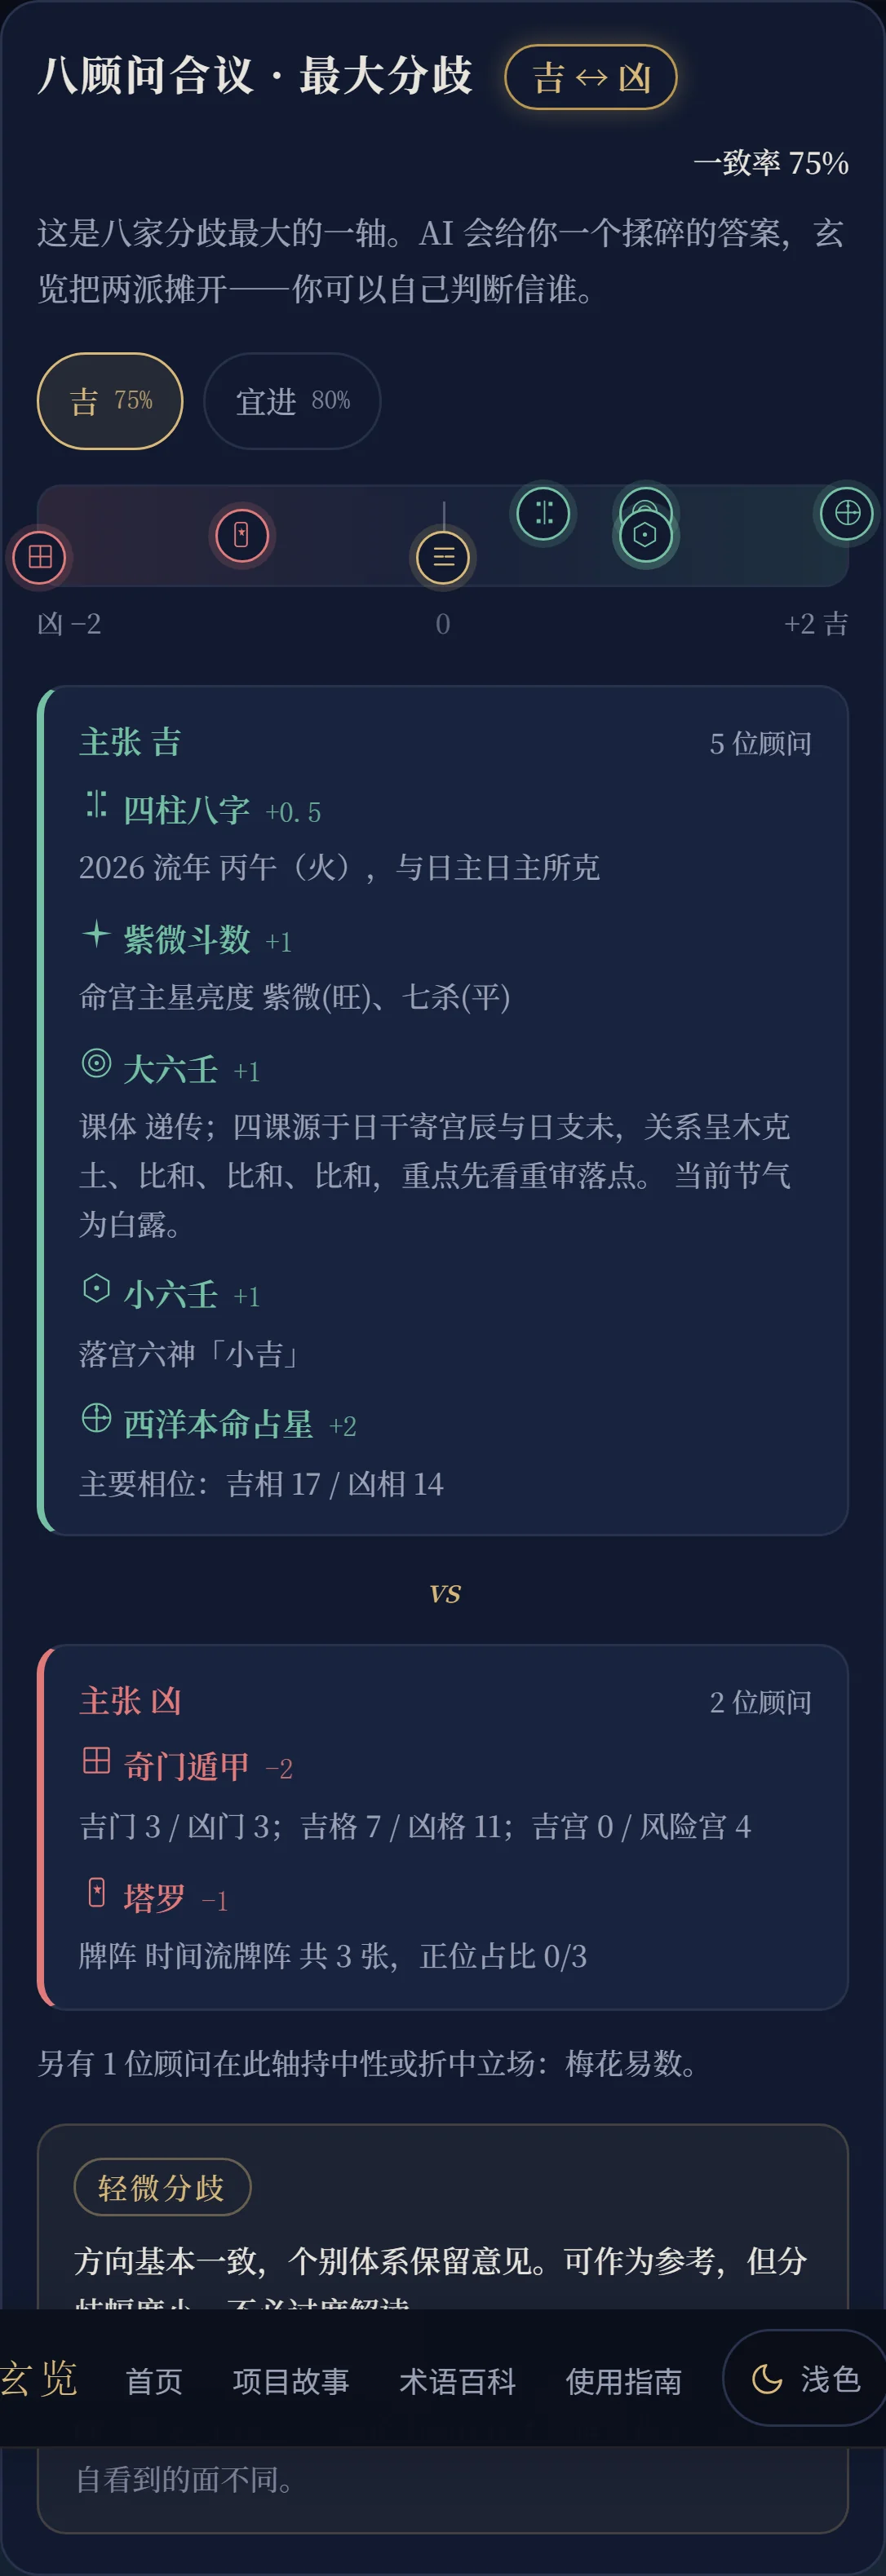
移动端是重新排过版的,不是把桌面版缩小:分歧视图在窄屏改成上下对照,标签栏变成固定底部导航,两派判词逐条可读。
我希望它能承担的是这么一件事:把”我该信谁”这个没法回答的问题,换成一个可以回答的问题——它们分歧在哪、分歧有多大、谁在唱反调。
后面这个问题有答案。而前面那个没有。
项目地址:GitHub · 玄览 在线体验(零安装,打开即用):qiaozt.pages.dev/xuanlan | qiao23333.github.io/xuanlan
下一期想聊聊它的发布通道:同一份产物为什么要发到两个地方,那道”会失败的同步门禁”是怎么设计的——以及怎么用 15 次真实网络抽样,发现原先那条通道有四成的人连页面都打不开。
顺带记一笔:写这篇文章核对线上状态时,我发现那条新通道其实从未真正上线——产物镜像和配套的站点集成改动一直留在工作区没有提交,线上那个地址返回的是 404。本地跑通、和线上真的在跑,中间隔着的是一次提交。这个坑值得单独写一期。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
