



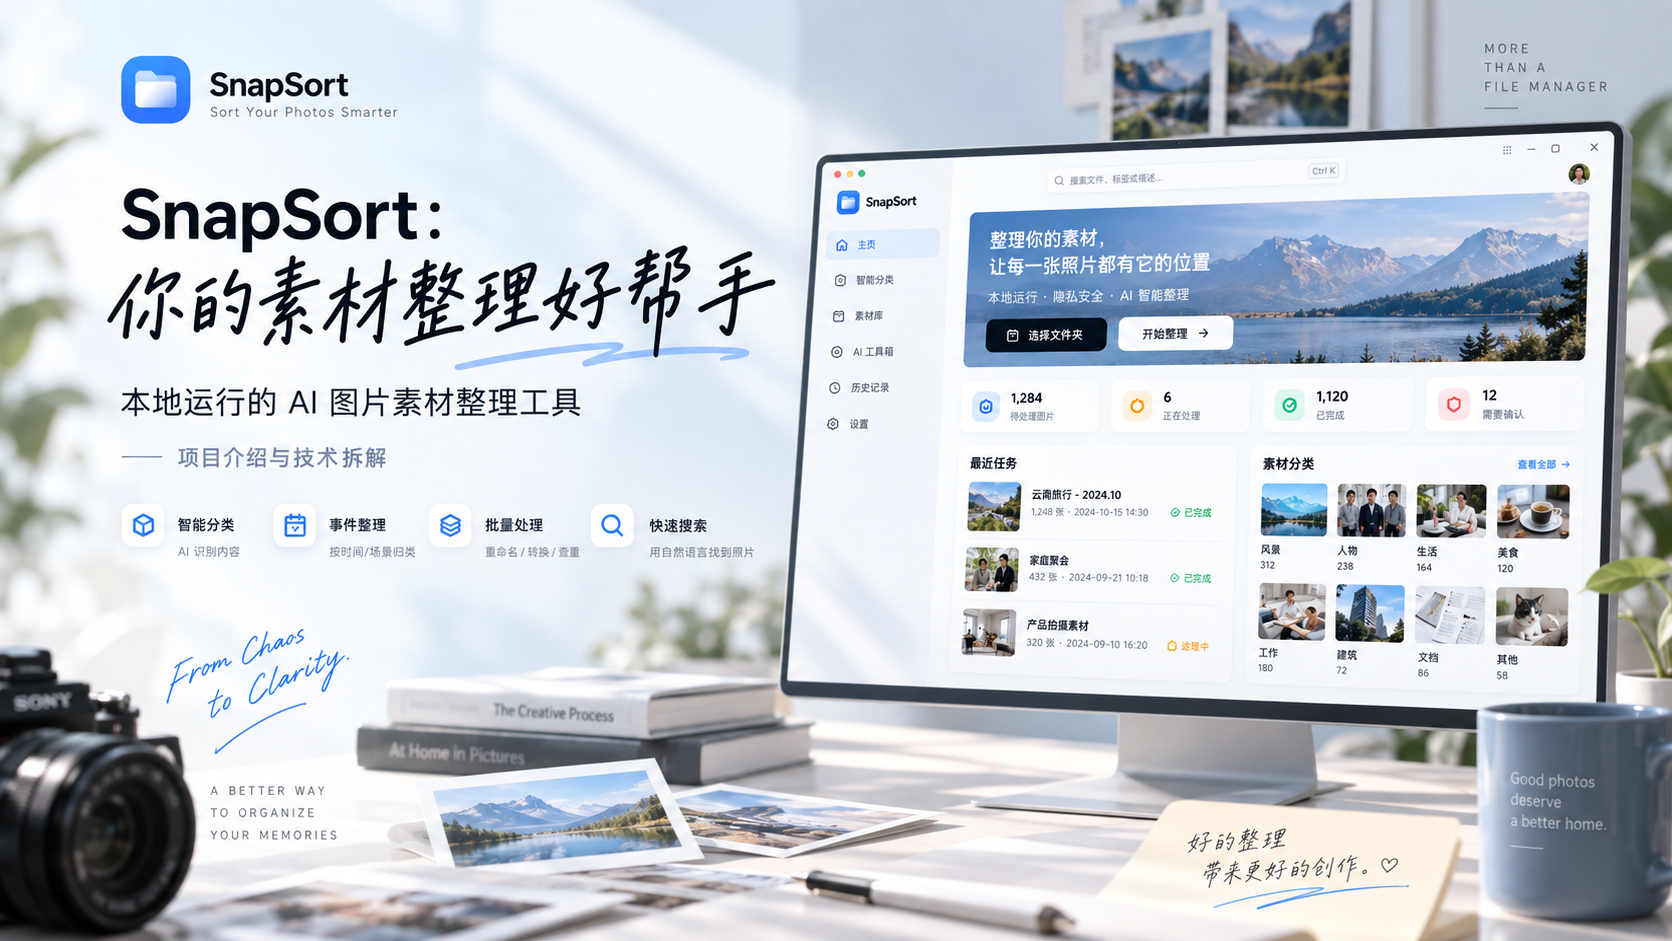
SnapSort:你的素材整理好帮手

现在你被要求整理成百上千张的照片素材,不仅要按照文件夹分好类,甚至每张照片都要按照特殊要求重命名。 照片存进去了,然后呢?
手机里的照片,导出来了;相机里的素材,也拷进硬盘了。新建一个文件夹,命名为”素材整理”,里面再套一个”待分类”。
至此,我们成功地把手机里的混乱,搬到了电脑上。
真正麻烦的通常是后半程:这张图是什么?应该放哪儿?上次那场活动的照片还有哪些?我明明见过一张很合适的配图,现在怎么翻不到了?
总不能自己一张张地找吧。
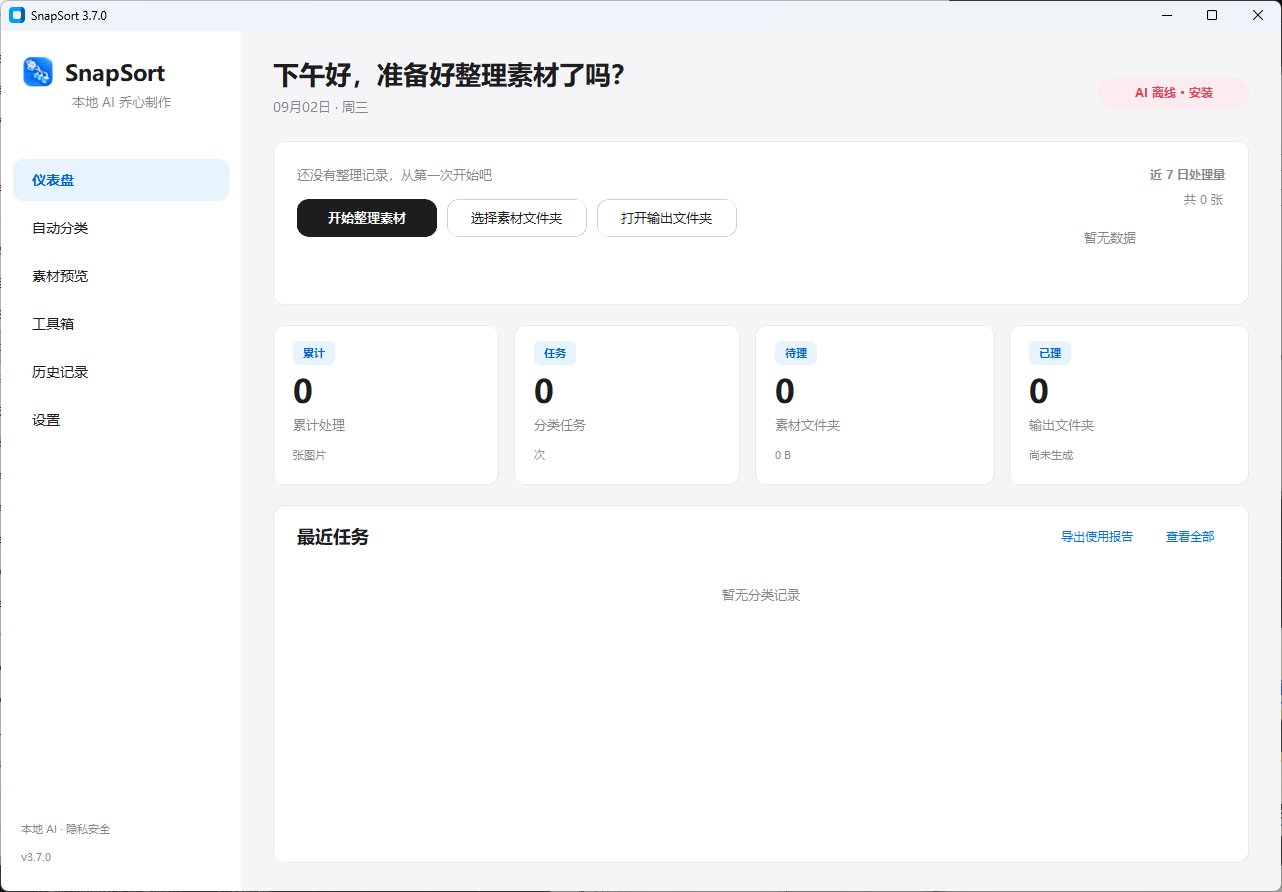
我做的 “SnapSort”,就是想处理这一段工作。它是一个本地运行的 AI 图片素材整理桌面工具,支持按内容或拍摄事件分组,也把重命名、查重、格式转换和图片搜索放到了同一个工作台里。
这篇带大家看看它能做什么、怎么用,以及几个功能背后的实现思路。
01 · 它适合处理什么样的麻烦?
“SnapSort”最初面对的是内容工作里的图片素材:来源分散,数量持续增加,最后还得拿来做选题、写文章、剪视频。
这里只讨论图片整理。视频工作会用到这些图片,但它不是一个能自动理解和整理整段视频的剪辑软件。
可以用三个场景理解它的用途。
第一种:我有一批图,想先知道里面都有什么。
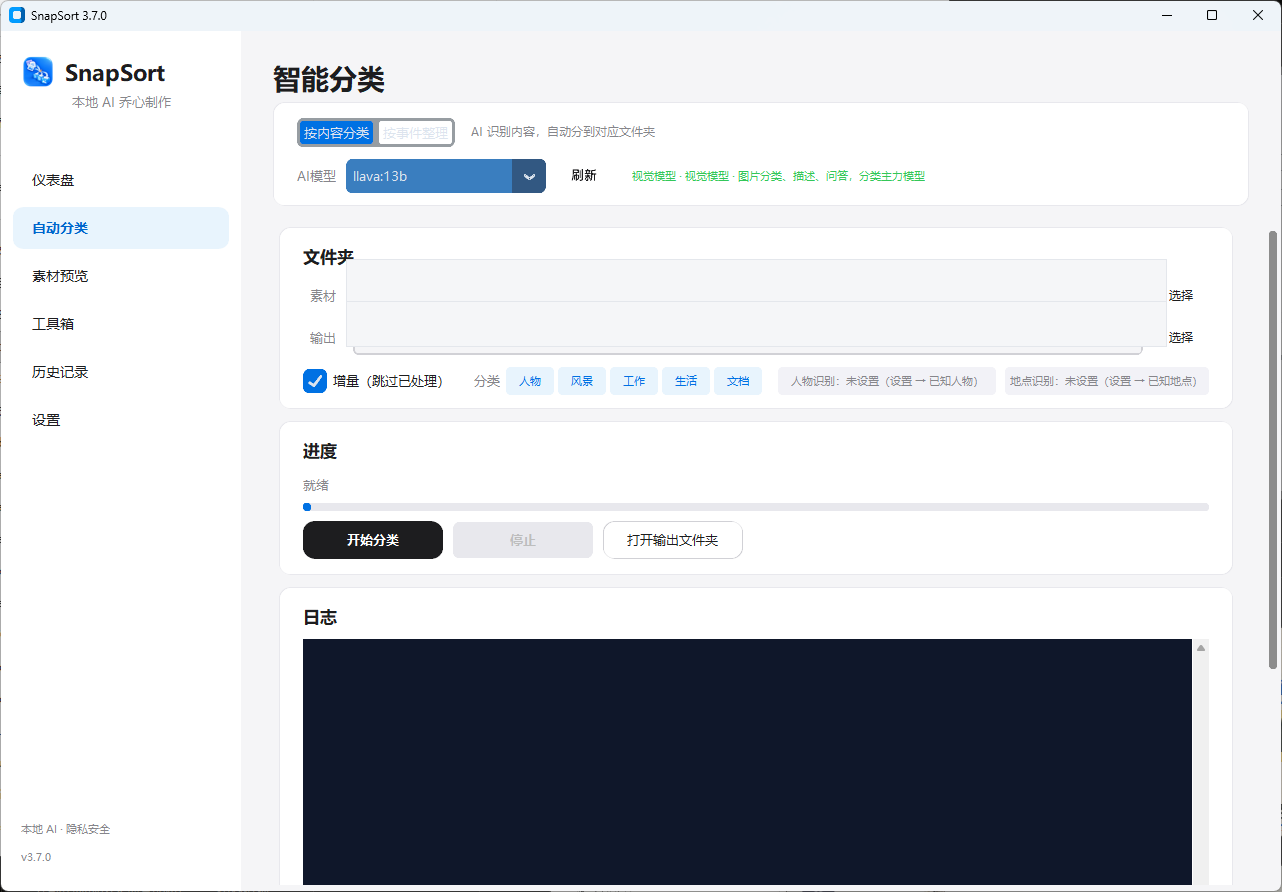
比如一份文件夹里混着人物、工厂、商务活动和日常照片。按内容分类,可以先把它们分到相应类别,再配合自定义名称和标签,减少逐张打开、判断、重命名的重复操作。
第二种:我需要的不是”所有工厂照片”,而是”上次参观工厂那一组”。
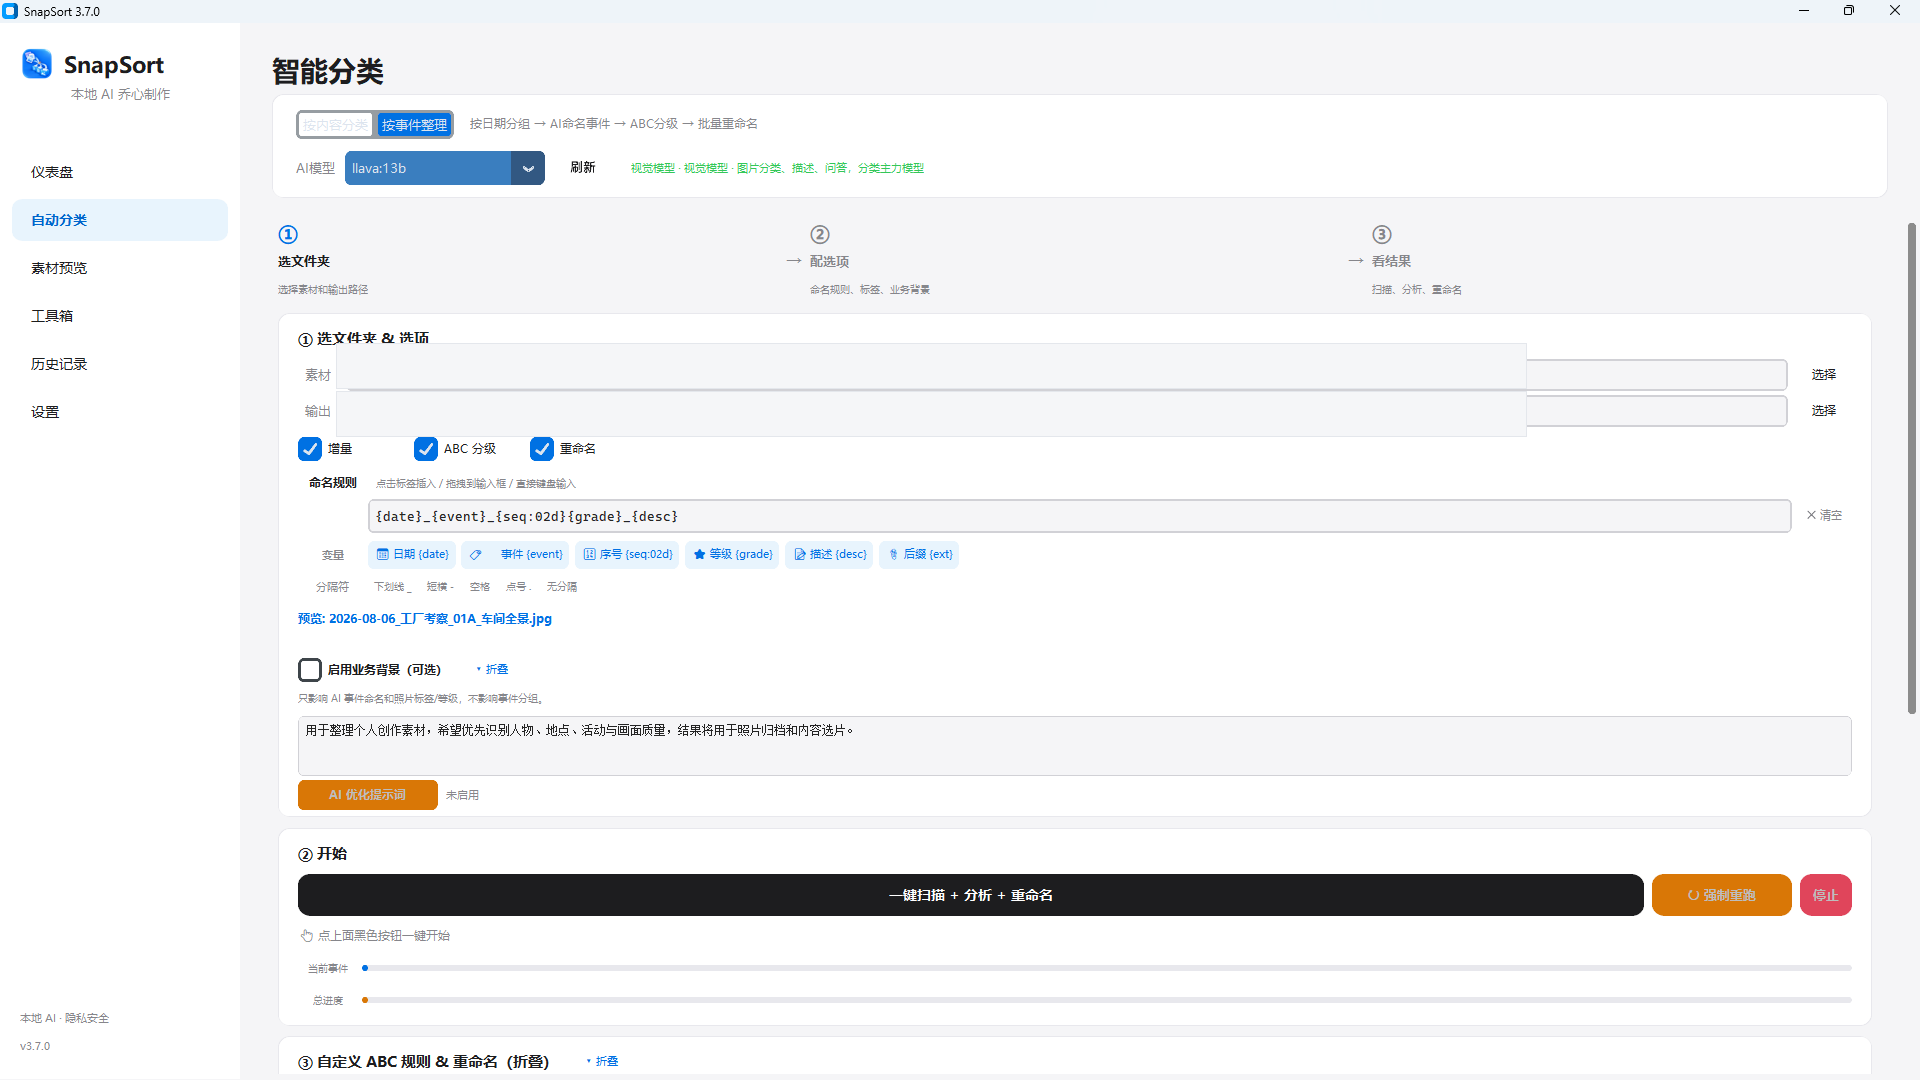
这时候,只有内容分类就不够了。一次活动可能同时有人物合影、设备、会议室和路上的照片,把它们各自分开,反而拆散了上下文。事件模式尝试把时间上连续的照片组织成组,更方便顺着一次活动找素材。
第三种:分好类了,但我还是想直接找某张图。
你可能记得画面里有设备、有某个人,或者是在某个地点拍的,却不记得文件名。图片搜索,以及人物、地点、对象的参考资料,就是为这类需求准备的。它们帮助缩小查找范围,结果仍然需要人确认。
简而言之:分类负责把柜子收拾好,搜索负责帮你找东西。柜子再整齐,也不意味着你记得每一层放了什么。
02 · 两种整理方式,对应两种找图习惯
我没有把”分类”做成只有一种答案的按钮。
内容模式回答的是”图片里有什么”,事件模式回答的是”哪些照片可能属于同一段活动”。两者都合理,取决于接下来要怎么使用素材。
| 你接下来的任务 | 更适合先用的方式 |
|---|---|
| 为文章寻找某类画面,例如设备、人物、建筑 | 按内容分类 |
| 整理一次出行、参观或活动的完整素材 | 按事件整理 |
| 已有明确目标,想找某个具体对象 | 图片搜索或参考图搜索 |
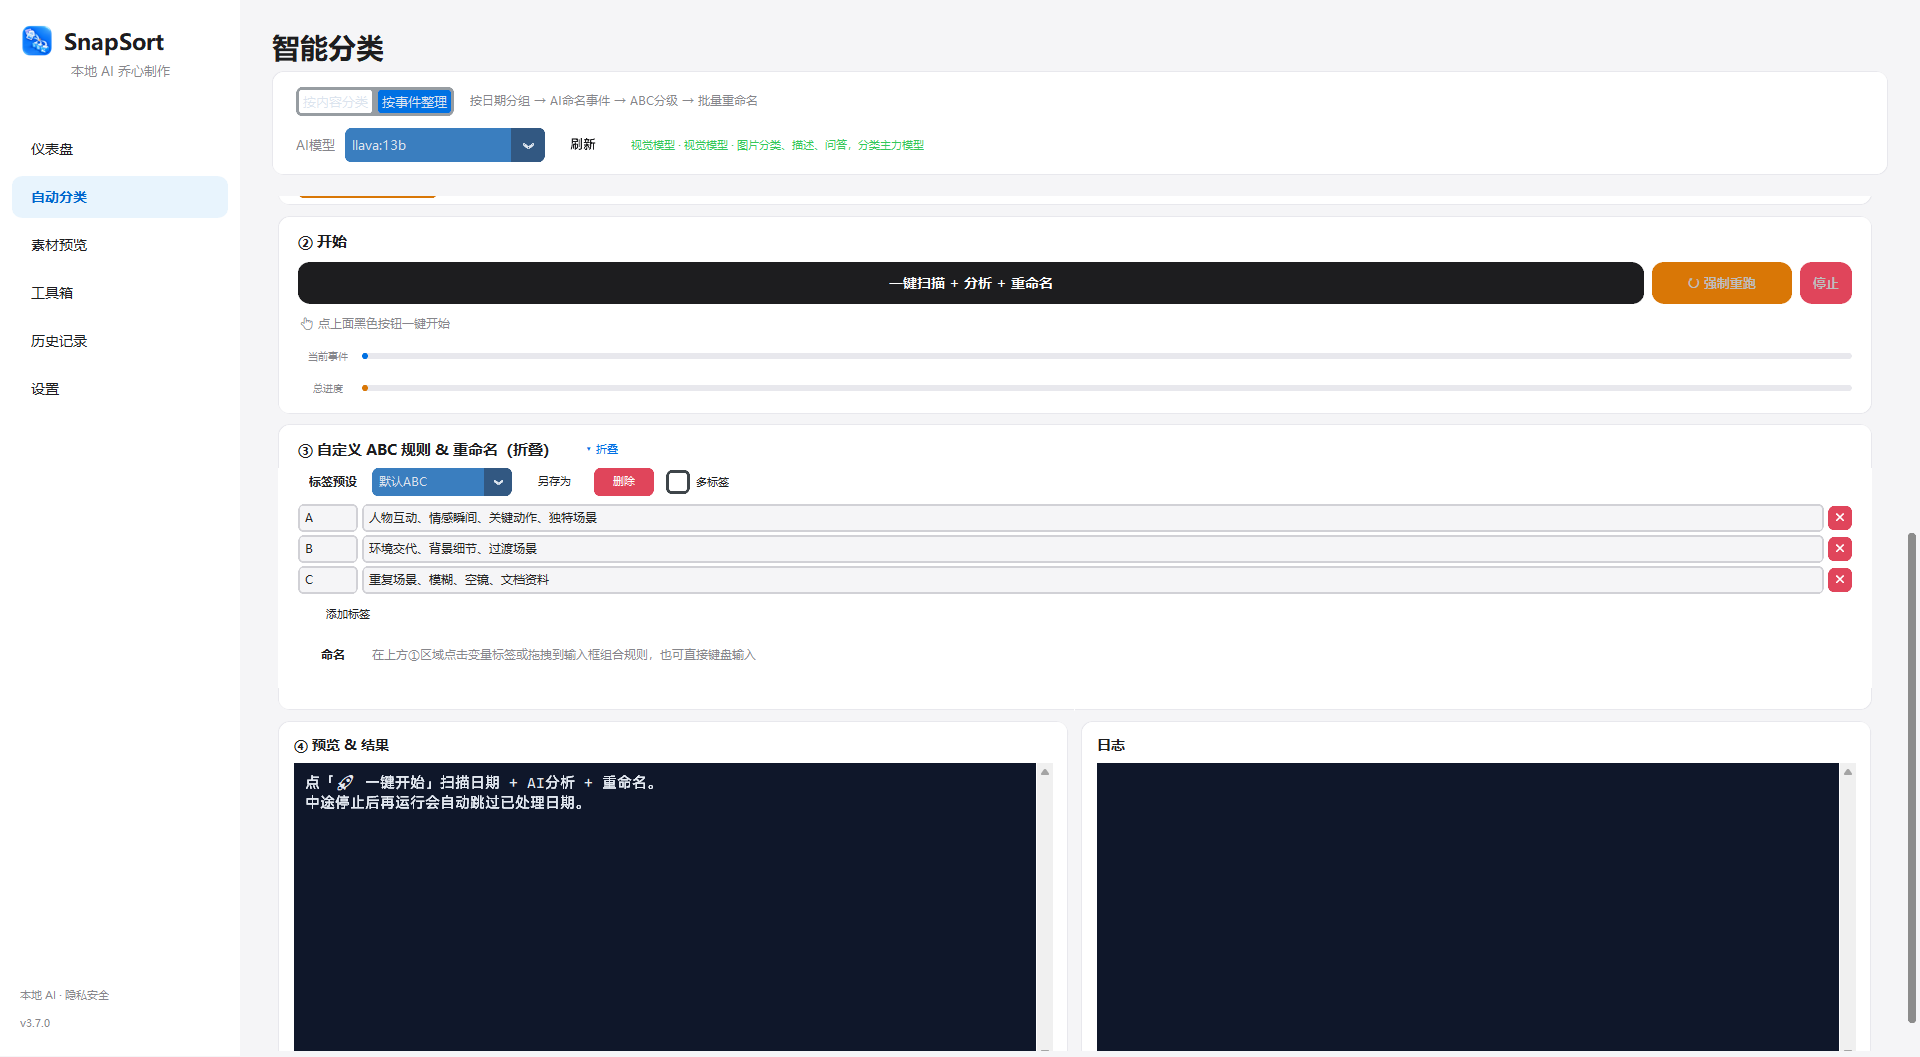
分类和命名规则也允许自定义。对摄影师有意义的标签,换到公司内容库里未必好用;同样是”人物”,有人关注构图,有人更关心人物在做什么。
因此,除了类别,SnapSort 还允许补充业务背景,以及按自己的标准设置分级规则。ABC 可以用来表达素材的优先级,但它不是一把放在哪里都准确的”照片价值尺”。标准需要先讲清楚,结果也需要复核。
03 · 第一次使用,先跑通一小批
现在的项目以源码运行方式为主。想直接体验,可以从 SnapSort 的 GitHub 仓库 获取代码。
准备环境
按项目当前安装说明,Windows 用户可以安装 Python 3.11 或更新的兼容版本,并在安装时勾选加入 PATH;进入项目目录后,运行 run.bat。macOS 对应的是 bash run.sh。
AI 识图依赖本机 Ollama。安装并启动 Ollama 后,可以使用项目文档提供的视觉模型示例:
ollama pull llava:7b如果还要使用文本智能助手,可以另外准备文本模型:
ollama pull qwen2.5:7b这些是项目文档中的配置示例,不是模型排行榜。下载模型和安装依赖需要网络;完成准备后,默认 AI 识图通过本机服务进行,不需要把照片上传到云端。具体速度取决于模型、图片和电脑配置。
只使用查重、格式转换、批量处理等非 AI 工具,则不需要先把模型环境搭起来。详细步骤以仓库中的 安装说明 为准。
走一遍整理流程
第一次先拿二三十张可以公开或不敏感的测试图跑通就好,不必一上来把整个硬盘当作见面礼。
- 选择输入和输出文件夹。 输入是待整理照片,输出使用另一个独立目录,方便核对结果。
- 选择整理方式。 想按画面找素材,就从内容模式开始;想保留活动上下文,就选事件模式。
- 设置规则。 内容模式重点看类别、命名和业务背景;事件模式重点看时间间隔、分级和命名选项。
- 先检查,再扩大批量。 事件模式可以先看分组预览;执行后,检查实际文件、分类和命名是否符合预期,再处理更大一批。
- 回到素材库浏览和找图。 需要时再使用搜索、查重、格式转换等工具,不必为了用完所有功能而制造工作。
业务背景可以写得具体一些。例如:
这批照片用于工厂参观内容,重点描述设备、生产环境和参观动作。无法确认的人物身份不要推断,不要把普通交流写成已达成合作。
这是一段配置示例。它能帮助模型理解你关注什么,但不是事实校验器;重要描述仍需要人工确认。
04 · AI 到底负责哪一段?
SnapSort 的桌面界面使用 Python 和 CustomTkinter,图片处理使用 Pillow 等组件,识图则通过本机 Ollama 服务调用视觉模型。
但从”选中一个文件夹”到”得到整理结果”,不是把整个任务丢给 AI,让它自由发挥就结束了。
让模型看图,让程序管流程
在内容分类里,程序把图片和分类规则、业务背景等信息组织成请求,交给视觉模型。模型返回描述和分类相关信息,程序再解析结果、应用规则,执行文件输出。
其中使用了场景、描述、人物、动作、情绪等结构化字段。这样做,是为了让模型的回答更方便被程序继续处理,而不是每次收到一篇格式随缘的小作文。
可以把这条流程简化成:
图片 + 分类规则 + 业务背景 ↓ 本地视觉模型识别 ↓ 解析结果、应用规则 ↓ 命名并输出文件结构化不等于不会出错,所以流程里还需要重试、异常处理和人工复核。模型可以帮忙判断画面,但不能仅凭一张合影,就知道里面每个人是谁、谈了什么、最后是否签了合同。
事件分组:从时间入手
当前事件模式的核心,是按日期或拍摄时间间隔分组。
在间隔模式下,程序读取照片时间并排序,比较相邻照片的时间差:超过设定阈值,就切出新的组;没有超过,就继续归到当前组。之后再结合模型做事件命名等处理。
比如把阈值设为四小时,上午拍摄和傍晚拍摄之间如果有足够长的间隔,就可能被拆开。它看的不是”是否同一天”这一条死线,连续的跨夜活动也不必因为过了零点就被一刀两断。
不过,时间只是线索。
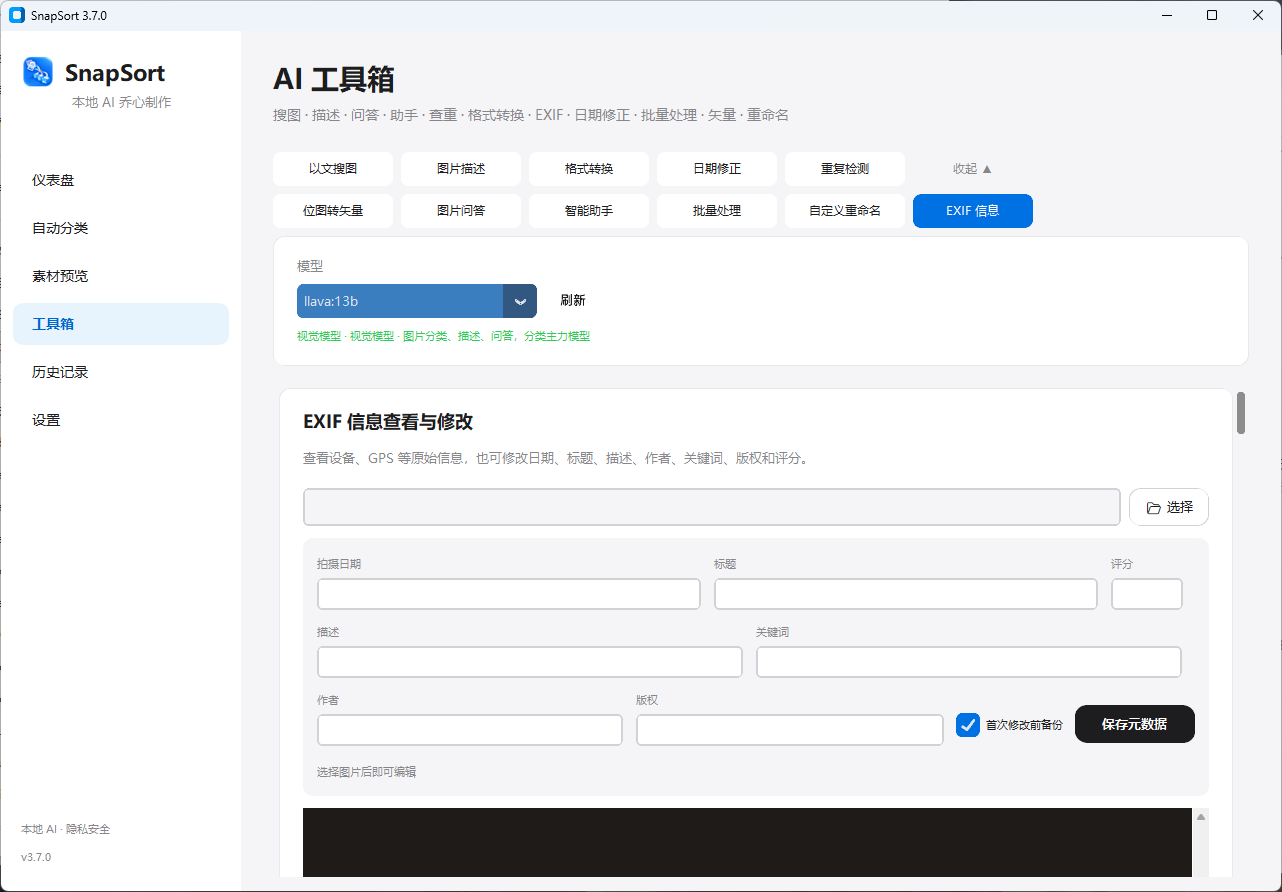
同一时间可能有两件事;一件事也可能间隔很久。截图、转发文件还可能缺少可靠的拍摄时间,程序退回使用文件时间时,分组就更需要检查。因此,项目也提供 EXIF 信息查看和日期修正工具。
当前不要把它理解成”AI 已经准确理解了全部活动”。结合图片内容辅助判断事件边界,仍是后续方向,不属于这里宣称已完成的能力。
中断恢复:不能靠 AI 起的名字认照片
同一张图,模型这次可能叫它”工厂参观”,下次可能叫它”车间交流”。如果只用输出文件名判断有没有整理过,结果很容易变成:同一张照片,领了两张不同的身份证。
内容模式因此使用源文件记录做增量判断,结合源路径、文件大小和修改时间识别是否需要重新处理;在没有现成记录、需要兼容旧输出时,还会用文件内容摘要辅助比对,而不是只比较 AI 生成的名字。
事件模式则使用另一套检查点:记录已经完成的事件分组标识,后续运行时跳过这些组。
两者不能混为一谈。事件检查点不是逐张照片的完整追踪系统;如果往已完成的日期组里追加照片,或大幅改变分组规则,就不能假设它会自动正确补齐。需要核对检查点状态,或在新的输出目录重新整理。
这些机制减少的是重复劳动,并非”任何时候关掉,任何改动后重开,都能毫无差别地续上”。
预览和搜索
预览图片看起来只是”显示出来”,但如果每次打开页面都解码一大批原图,界面很容易直接卡死挂掉。
素材库采用后台线程生成缩略图、磁盘缓存和分批渲染。缓存标识包含文件路径、修改时间、大小等信息:没有变化的图片尽量复用缩略图,有变化再重新生成。
搜索也有类似考虑。以具体对象的参考图搜索为例,程序把参考图和候选图片分批交给视觉模型,并缓存匹配结果。下次目标配置和图片都没变,就复用结果;换了参考图、模型或目标描述,则需要按新的条件判断。
这意味着首次搜索仍可能比较慢。缓存省下的是重复计算,不会把第一次识别凭空变没。项目还提供可选的 CLIP/FAISS 索引加速路径,但它不是默认使用图片搜索前必须安装的一整套环境。
05 · 除 AI 外的一些思路
工具里最显眼的是 AI,除此之外还有些没那么起眼但很重要的创造思路。
整理时复制输出,保留原件。 分类不满意,可以调整规则再试;代价是占用额外磁盘空间。这条保护针对分类整理流程,不代表所有工具操作都不改变文件,例如批量修改元数据前,仍然应该保留备份。
本地优先,但不掩盖配置门槛。 默认不上传照片,适合不希望把工作素材交给外部识图服务的场景;相应地,模型安装、磁盘空间和推理性能也要由自己的电脑承担。
规则可以调整,但判断权不全交给模型。 用户比模型更清楚照片的背景。参考资料和业务说明可以补充上下文,却不能让模型获得它原本不知道的事实。
辅助工具服务于整理过程。 HEIC 转换、重复检测、日期修正和自定义重命名,解决的是素材进来以后会遇到的具体问题。相似图片也未必就是废片,查重结果值得看一眼,不能把”长得像”直接等同于”可以删”。
06 · 它现在是什么,还不是什么
目前的 SnapSort,是一个已经具备内容分类、时间分组、图片检索和常用整理工具的本地桌面项目。
它还不是一个开箱即用、适配所有电脑的大型素材管理平台,主要功能需要下载本地 AI 模型,也不保证 AI 分类、命名和参考图匹配每次都准确。大量图片的处理速度、不同模型的表现,以及各种来源的时间信息,都还需要在实际数据里验证。
我希望它能承担的是第一轮重复劳动:先把散乱的图片变成可以浏览、搜索和继续校对的素材,再由人判断哪些值得用、应该怎么用。
毕竟,照片被放进文件夹,只能说明它被存下来了。下次需要时能找到、能看懂、能拿来用,这次整理才算真的帮上了忙。
项目地址:GitHub · SnapSort
下一期聊它的另一面:一次素材整理任务,怎样一步步变成了这个工具;以及那些一开始觉得合理、真正用起来才发现需要重做的决定。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
