



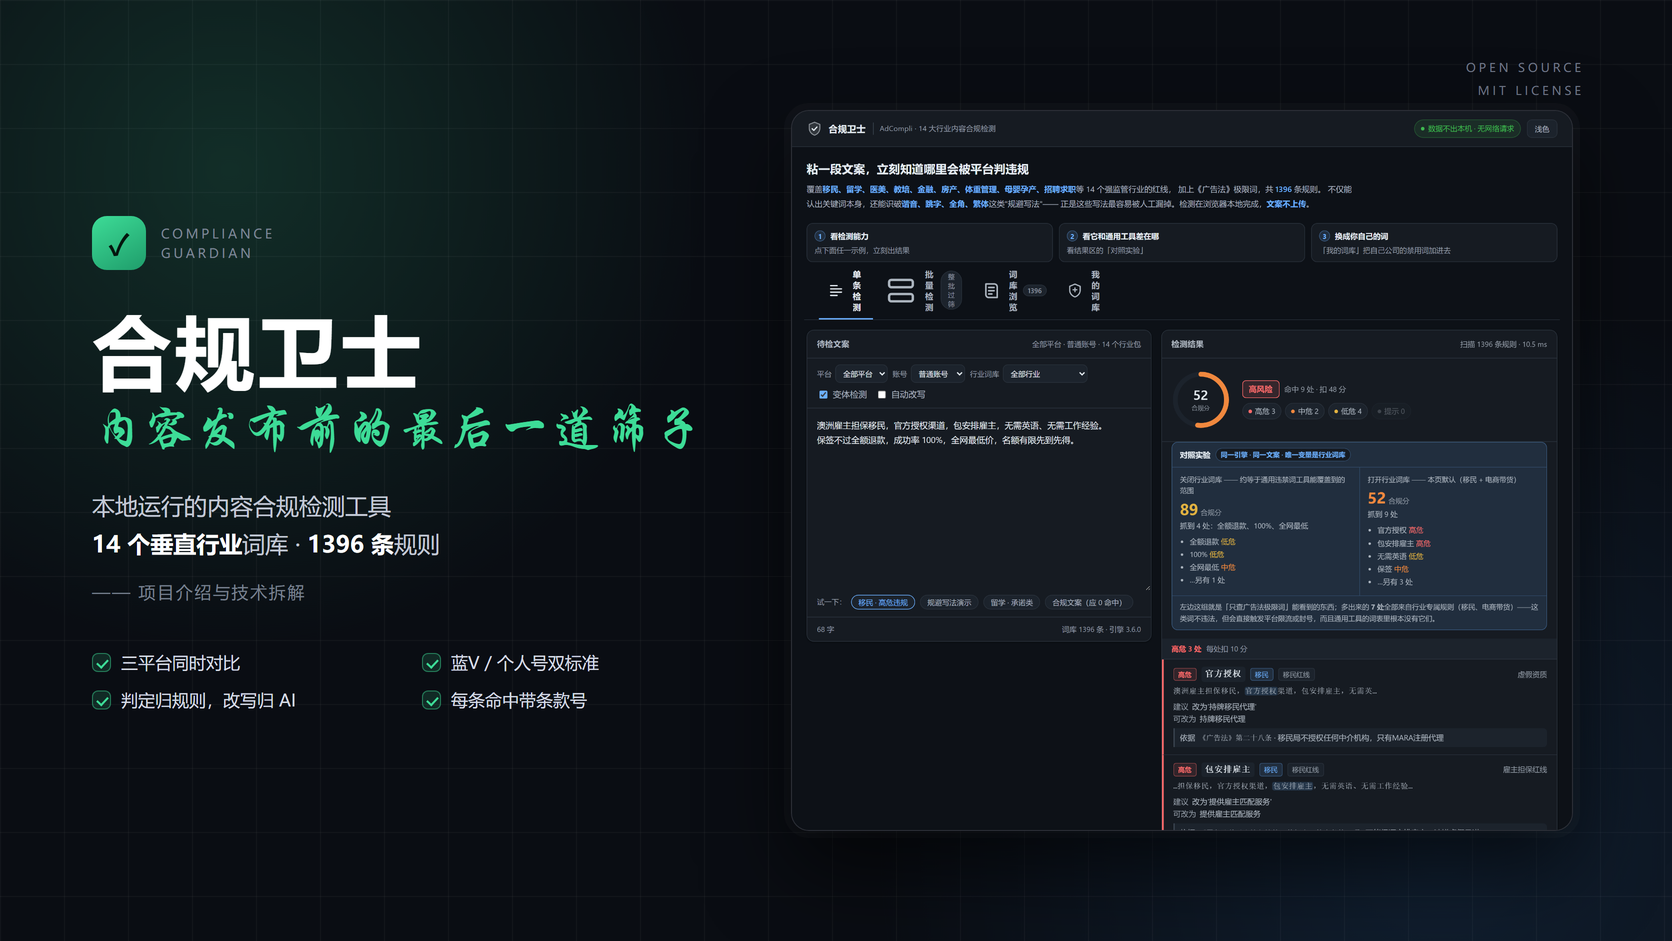
合规卫士:内容发布前的最后一道筛子

一条内容从写完到发出去,中间隔着几道关。
平台规则一套,账号类型一套,行业监管又是一套。你写”保证下签”,《广告法》说这是虚假承诺;你写”内部名额”,行业监管条文说这是违法操作暗示;同一句话,在小红书发没事,在抖音可能就限流。
每发一条,都要人工来回核对这几个维度。累,而且不可靠——人不是靠枚举法工作的。
我做的”合规卫士”,想把这一段判断接过去。它是一个本地运行的内容合规检测工具,把行业红线 + 平台差异 + 账号类型三层判断做成一次检测,并对每条风险给出可以直接采用的改写建议。
这篇介绍它能做什么、怎么用,以及几个功能背后的实现思路。
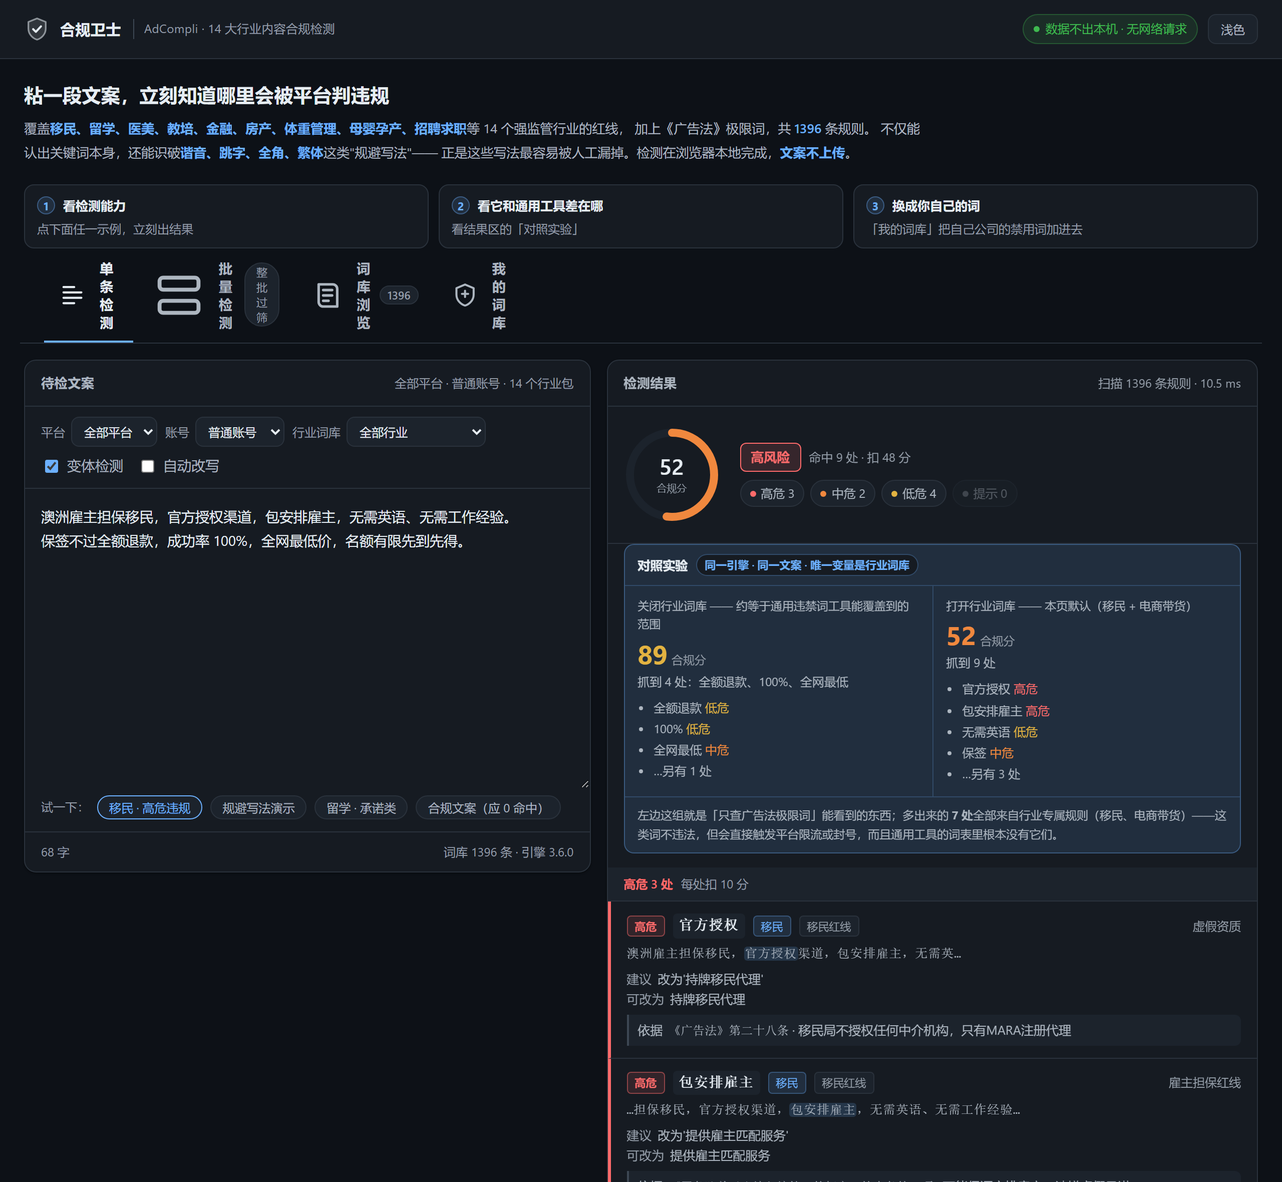
01 · 通用违禁词工具为什么不够用
市面上已经有句易网、零克查词这类工具,它们做得不差,但解决的是另一个问题:广告法极限词。
而垂直行业的合规红线,几乎全在通用词库之外。
| 违规表述 | 性质 | 通用工具 |
|---|---|---|
| 保证下签 / 包过 / 成功率 100% | 虚假承诺 | 不覆盖 |
| 内部关系 / 内部名额 | 违法操作暗示 | 不覆盖 |
| 现成雇主 / 挂靠雇主 | 雇主担保红线 | 不覆盖 |
| 3 个月必拿 PR / 保证 X 天获批 | 时间承诺 | 不覆盖 |
| 全网最低价 / 不成功全额退款 | 费用承诺 | 部分覆盖 |
所以它从设计上就不是”又一个违禁词检测器”。
界面里有个我挺喜欢的小设计,叫对照实验:同一段文案,同时算两个分数——一个是关掉行业词库的(≈ 通用工具能看到的世界),一个是打开行业词库的。
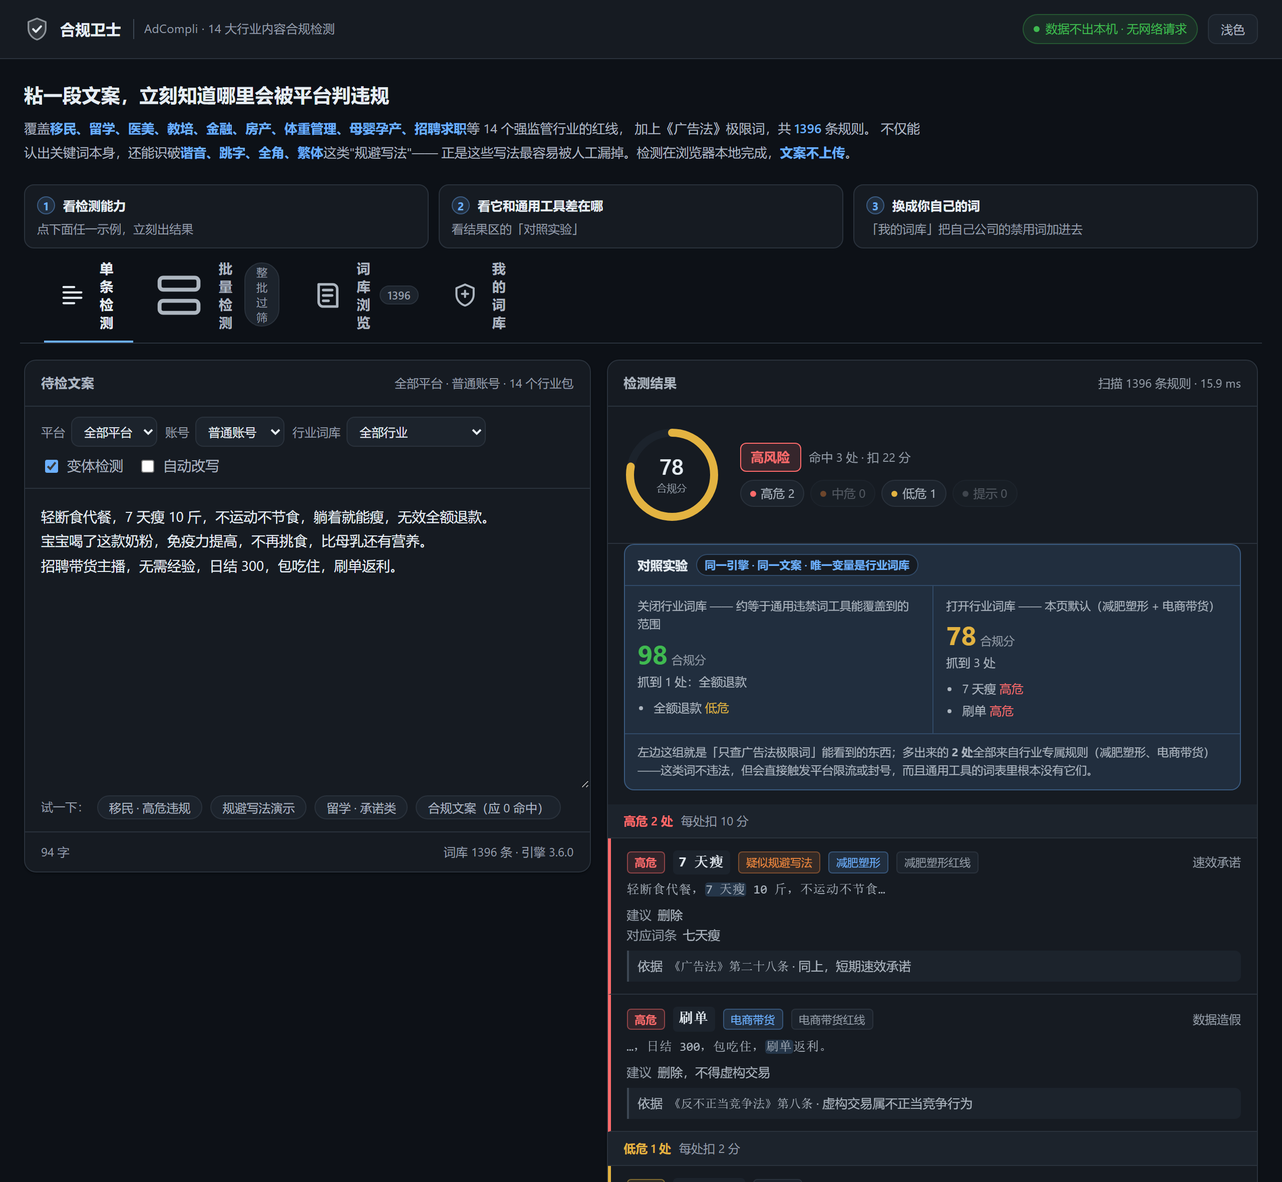
上面这张图里,通用口径给 98 分,行业口径给 78 分。差的 3 处全来自行业专属词库——这些词不违反广告法,但会直接触发平台限流或封号,而通用工具的词表里根本没有它们。
这不是说通用工具不好,是各自要解决的问题不同。
02 · 三层判断,做成一次检测
第一层:平台。 同一段文案,一次给出小红书 / 抖音 / 视频号的独立判定,并归因差异来源:三平台分数并列时,它会明说”判定一致,命中的是跨平台通用规则”,而不是编一个不存在的结论;存在差异时,会指出哪个平台有独有的风险词。
第二层:账号类型。 蓝V企业号和个人号的尺度不一样。有 57 条限制只对蓝V生效——比如”保健食品”这类表述,非蓝V发出去算违规,蓝V只是提示。这层差异在引擎里必须从输入一路传到判定,中途写死一次,分档就整体失效了。
第三层:行业。 目前内置 14 个行业包,共 595 条:
| 行业包 | 条数 | 主要依据 |
|---|---|---|
| 移民 / 出境入境 | 171 | 《国务院关于出境入境管理的规定》(国务院令第 841 号)第十条六条禁令 |
| 医疗美容 | 52 | 《广告法》第十六条、第十七条 |
| 教育培训 | 42 | 《广告法》第二十四条 |
| 食品保健 | 39 | 《食品安全法》第七十三条 |
| 房地产 | 37 | 《广告法》第二十六条 |
| 电商带货 | 36 | 《广告法》第二十八条 |
| 金融理财 | 35 | 《广告法》第二十五条 |
| 美妆护肤 | 33 | 《化妆品监督管理条例》第四十三条 |
| 留学 / 升学 | 30 | 《广告法》第二十四条 |
| 体重管理 | 26 | 《广告法》第十七条、第二十八条 |
| 母婴孕产 | 24 | 《广告法》第二十条(禁止声称替代母乳) |
| 招聘求职 | 24 | 《人力资源市场暂行条例》第二十四条、第二十七条 |
| 法律咨询 | 23 | 《律师执业管理办法》第三十三条、第四十二条 |
| 宠物 | 23 | 《广告法》第二十一条(兽药、饲料广告) |
行业包是可插拔的:新增一个行业不需要改内核代码,只要在 rules/industry_packs/ 下加一个目录(pack.json + rules.json),前端的选择器和来源标签会自动跟着更新。
但有两条硬规矩:每个包的关键词必须 100% 写 law_ref,且不得与旧库或其他包撞名——同一处命中挂两个来源,用户就说不清按哪条算分。这两条都写了测试守着。
03 · 第一次使用,先跑通一条
想直接体验,打开在线页就行,零安装、不用注册,文案不出浏览器:
https://qiaozt.pages.dev/guardian/
页面是纯静态的,并且做了 PWA——装到桌面或手机主屏之后,第一次打开过就能断网使用。测试里是真的开了离线模式再刷新的,验的是”拔了网线照样跑”,不是”Service Worker 注册成功”。
桌面端功能更全(批量扫描、历史库、拼音变体通道),源码在 GitHub 仓库。
第一次用建议这样走:
- 粘一段文案,看看反应。 页面上有内置示例,最短的路径是点一下”移民 · 高危违规”。
- 看一眼对照实验。 它最能说明这个工具和通用工具的关系。
- 改一遍,再检测一次。 这是真实工作节奏。
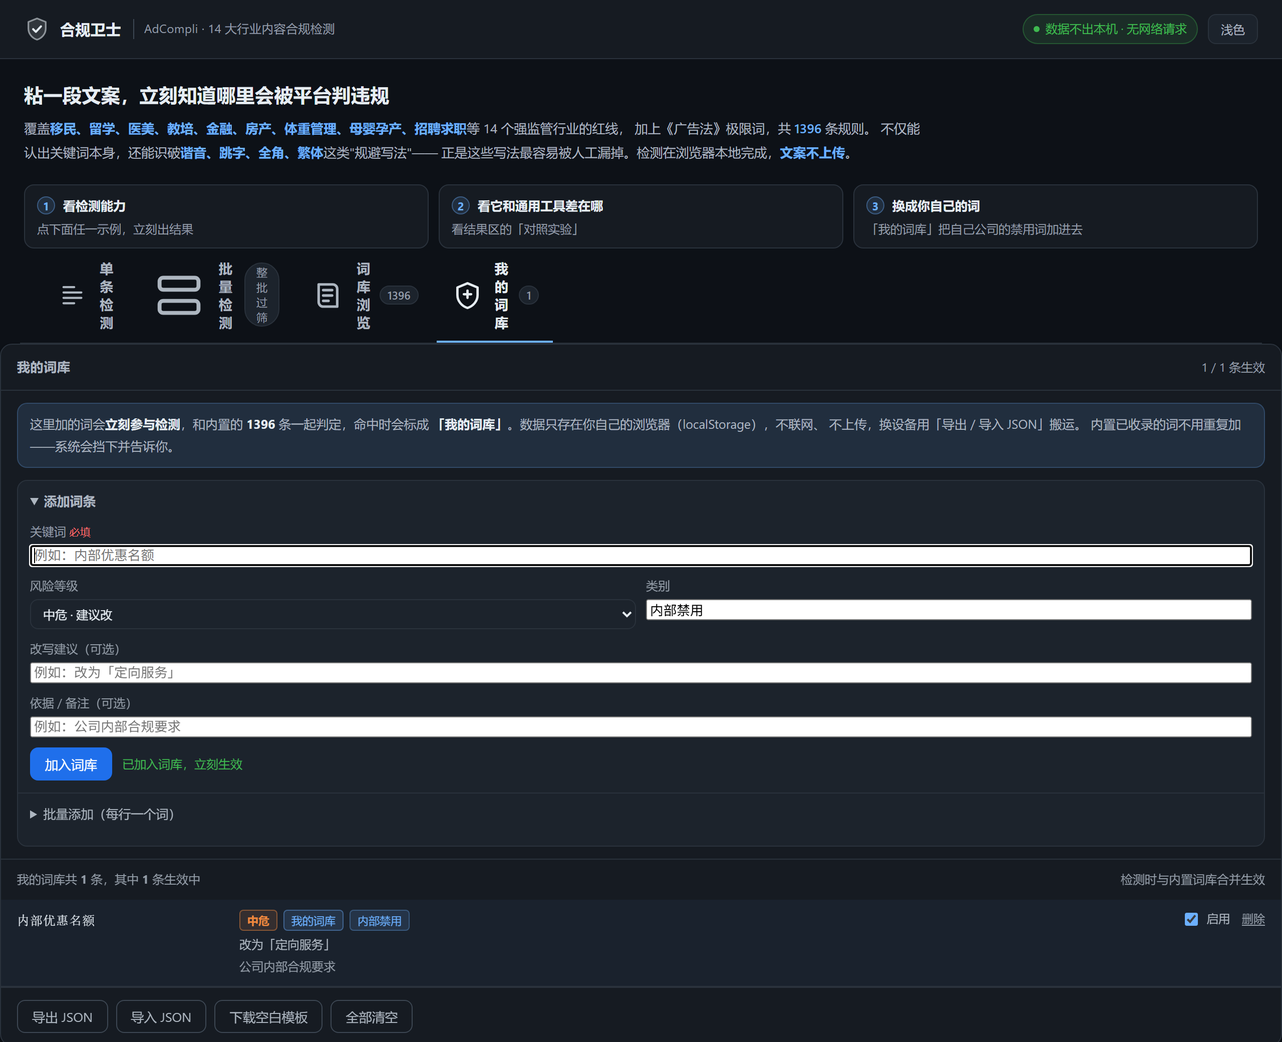
- 换成你自己行业的文案。 如果词库里没有你的行业,用「我的词库」自己补。
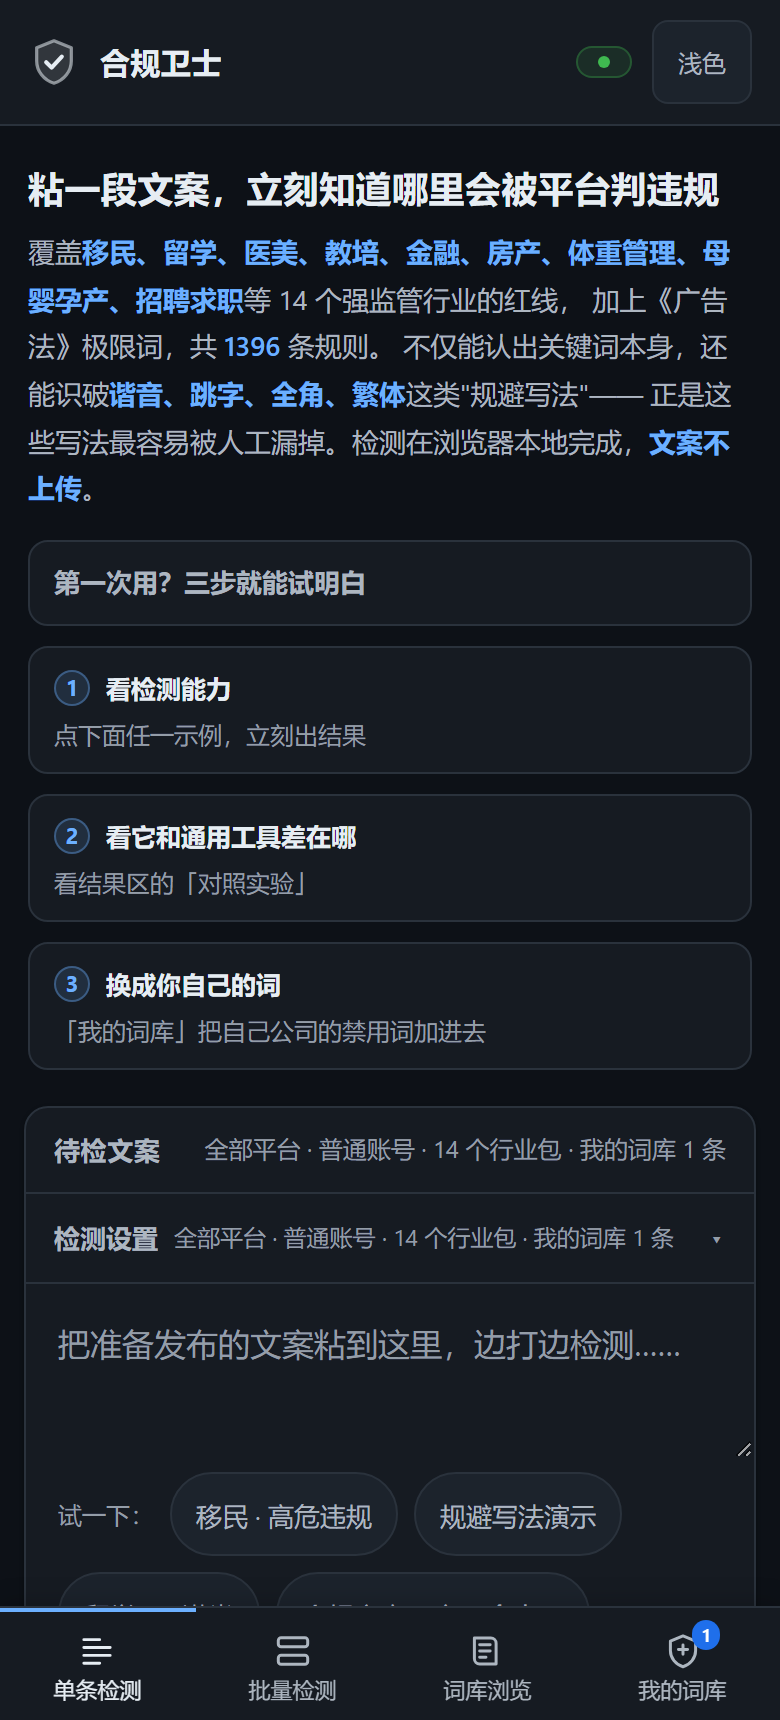
移动端是重新排过版的,不是把桌面版缩小:标签栏在窄屏变成固定底部导航,检测设置自动折成一行摘要(直接写出”三平台 · 普通号 · 移民”),不用展开也知道自己在测什么。
04 · 最难的部分:让工具别乱报警
对合规工具来说,误报比漏检更致命。
漏检是没帮上忙,误报是帮倒忙——运营被误报烦几次,就直接不用了。这个项目在早期评测里,误报率是 35.5%,也就是说每三条合规文案就有一条被判违规。
问题出在中文本身。“第一”既可能是绝对化宣传(“行业第一”),也可能是普通序数(“第一步 / 第二阶段 / 第3步”)。纯词表匹配会把后者全部误报,而这类句式在文案里出现频率极高。
解决办法是把判定拆成两层:
- 规则层负责命中:关键词表决定”这里有嫌疑”。
- 语境层负责否决:短语表(最近 / 最后 / 最终)+ 语法模式(
第X + 步|阶段|章|篇|次这类可穷举骨架)。
判定规则是:命中区间被豁免区间完全覆盖时,才算豁免。
这条规则很关键。所以”销量第一""位列行业第1位”照样全部报出来,而”我排在第1位""第2步递交材料”不再误报。放宽与收紧是成对设计的,不是单边放宽。
最终指标(内建评测语料,跑一次几秒钟):
| 指标 | 改造前 | 当前 |
|---|---|---|
| 误报率(合规文案被误判) | 35.5% | 0% |
| 漏检率(违规文案连提示都没有) | 26.7% | 0% |
| 仅提示率(只判警告未判违规) | — | 5.4% |
评测口径本身就是个坑,值得单说:早期版本不传行业参数,读的是配置文件里写死的 ["immigration"]。结果新加的 7 个行业包、313 条规则从未被评测过,而”误报率 0%“被当成卖点写着。现在口径写死为”磁盘上全部行业包开启”,并且语料按行业分档——每个行业包都必须有正反语料,否则门禁直接报红。
05 · 一个漏检是怎么被找出来的
技术部分我最想讲这个案例,因为它不是”写代码时发现的”,是”用的时候撞见的”。
给这篇文章截演示图时,我随手编了一段减肥 / 母婴 / 招聘的文案丢进去,想看看新加的行业包表现如何。结果很尴尬:词库里明明有「七天瘦」,文案里的「7天瘦」却完全没提示。
词条没写错,是引擎少了一条通道。中文数字有阿拉伯和汉字两套写法,使用边界纯凭手感——“7天瘦”和”七天瘦”是同一种违规表述,而每个关键词只能收一种写法,另一种就成了漏检口子。偏偏”7天瘦10斤”才是减重类内容最常见的写法。
修复思路看起来很简单:匹配之前把阿拉伯数字换成中文数字就行了。
我第一版就是这么做的——直接在归一化管线里加一步替换。然后对拍门禁当场报红:
✗ 成功率100%,绝无例外 Python: 基本合规 [] JS : 中风险 [('成功率100%', 'high', 'variant')]原因是全角「100%」原本靠”全角→半角”归一后命中关键词「100%」,数字被转成”一零零”之后再也匹配不上了。修一个漏检,砸掉另一个能力。
根因在两类东西的性质不同:
- 归一化管线解决的是规避花招——空格、谐音、繁体、全角。这些写法本身不合规范,还原成规范形式是对的。
- 数字是同一表述的两种合法写法——“7”和”七”谁也不是错别字,不存在”哪个才是规范形式”。
混在一起做,就会让”还原花招”这条职责被污染。
所以最终方案是把数字单独拆成一条通道:归一化结果保持原样,之后再把阿拉伯数字逐字符换成中文数字匹配一遍。命中标记为变体,高亮仍然回落到原文,卡片上会同时标出「对应词条:七天瘦」,可追溯。
两个细节值得记下来:只做单字符映射(0-9 与 零-九 都是 1 个字符,属等长替换,转换后坐标可直接复用,高亮位置不会漂);多位数不做("10"→"十" 会改变长度、击穿坐标回映射),这属于当前机制明确的已知边界。
这个项目有一套双端对拍机制:Python 内核和浏览器里的 JS 引擎各自实现一遍判定逻辑,由测试拿同一批语料跑两边,结论必须逐条一致。上面的回归就是它当场抓到的——如果没有这道门禁,这个 bug 会一直活在线上,表现形式还是最阴的那种:页面照常工作、不报错,只是某类文案悄悄漏检。
06 · AI 只做改写,不做判定
这是我对”AI 该用在哪”最明确的一个回答,也是和”把文案丢给大模型让它判违规”那类做法的根本区别。
判定交给规则引擎。判定要确定、可复现、可追溯——模型会漏检、会凭空发明违规、同一句话问两次给两个答案。合规判断是要能拿去跟平台申诉、给法务看的,这种场合容不下不确定性。
改写交给语言模型。这是语言活儿:规则库给不出”保签包过”该改成什么,才能既有说服力又不承诺结果。
提示词里把这条边界写死了(明确要求”不要做合规判定”,并说明原因)——只写”要什么”不够,模型会很热心地顺手多做一步。
这里还有个我认为挺重要的设计:不配任何模型,AI 改写也能用。点「复制改写指令」,工具会把规则引擎的精确命中(含法条来源与可用替换词)连同改写约束打包成一段文本。粘到任意 AI 里就有结果——零注册、零 API Key、零成本,文案也不经过任何服务器(这个工具确实没有服务器,所以体验页能纯静态部署)。
另外,AI 的产出必须人工复核。界面上逐处标明”改前 → 改后”,模型明说改不了的会如实呈现,不硬凑方案。
07 · 规则会安静地过期
这是这类工具最大的真实风险,也是最容易被忽略的:
检测准确率再高,也只对”词库写下那天”的规则成立。平台规则几个月一改,监管口径随政策走。功能不报错、测试不变红、页面照常给分数——只是分数开始失真。
规则驱动型工具不是死于做不出来,是死于没人维护。
所以做了两件事让它”会失败”:
rules/review_log.json记录每个来源的依据、上次复核日、复核周期、复核要点。Web 端词库页顶部的「词库健康度」把它变成能扫一眼的指标。scripts/check_rule_freshness.py超期即返回非零退出码,已进 CI。它还会指出”词库里有、台账里没登记”的来源——忘了登记就永远不会被提醒。
有个细节:台账里只存事实(复核日、周期),“还剩几天”由浏览器现算。把算好的剩余天数写进产物,产物就会每天漂移,双端对拍门禁会天天变红。
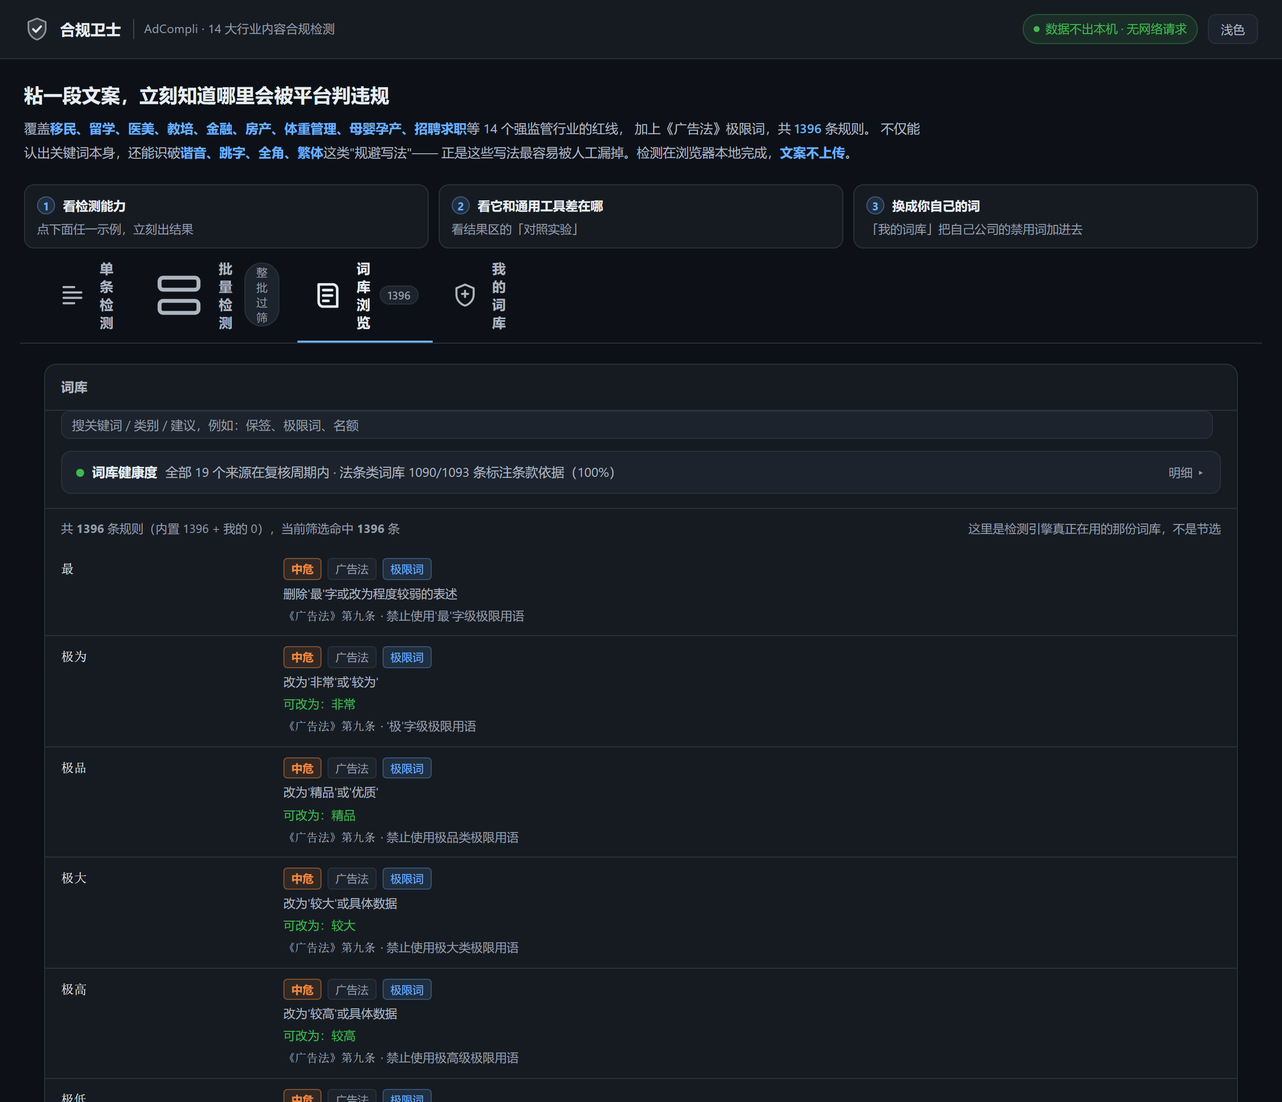
顺便说个同类问题的延伸。写这篇文章时,我发现 README 里写的条款覆盖率是”610 / 710(约 86%)“,而词库页实际显示的是 1090 / 1093(99.7%)——因为后者是产物自动算的,前者是手写的,扩了行业包之后不会自己变。
同一份事实存了两处,早晚会对不上。所以顺手加了两道门禁:README 引用的规则条数与覆盖率必须与词库一致,README 写的测试用例数必须与 pytest --collect-only 的实际收集数一致,对不上就报红。
08 · 它现在是什么,还不是什么
目前它覆盖 14 个行业、1396 条规则,其中 1090 条带具体条款依据;行业包 100% 带条款号。测试 378 个 pytest 用例 + 160 项浏览器冒烟 + 全站对比度审计。
它还不是一个能替你下判断的法务系统。几个明确的边界:
- 它是文本检测,不理解语义。 靠词表 + 正则 + 语境模式,判断不了”反讽""引用""辟谣”这类语境。这是刻意的取舍——判定必须可复现,所以不把模型的不确定性引进来。
- 语境豁免只覆盖”紧邻搭配”。 否定语境的豁免靠短语表,命中词与否定词中间夹了别的词就覆盖不到(“不使用任何刷单手段”)。放宽成”出现否定词就豁免整句”会拿漏检换误报,宁可保守。
- 数字写法只覆盖单字符。 “7天瘦”能命中「七天瘦」,但”10天瘦”不会命中「十天瘦」,原因见上文。
- 行业包只有 14 个。 这是目前能核实到法条依据的范围。再加行业需要真的查清该行业的监管条文再写——宁可少,也不要塞一堆没依据的词。你的行业不在里面,可以用「我的词库」自己补(本地存储,可导出 JSON)。
09 · 改稿闭环,而不只是一把尺子
最后说一个我觉得被低估的功能。
内容运营的真实节奏是检测 → 改 → 再检测 → 再改,所以光有一把尺子不够。
Web 端可以「存为改前」建立基线,之后每改一次就实时给出:改前分 → 改后分、已消除几处、仍未处理几处,以及——新引入几处。
最后这个才是重点。改文案时改出新违规是常态,而多数工具只告诉你”还剩几处”,不告诉你”你刚才那一刀又砍出个新问题”。
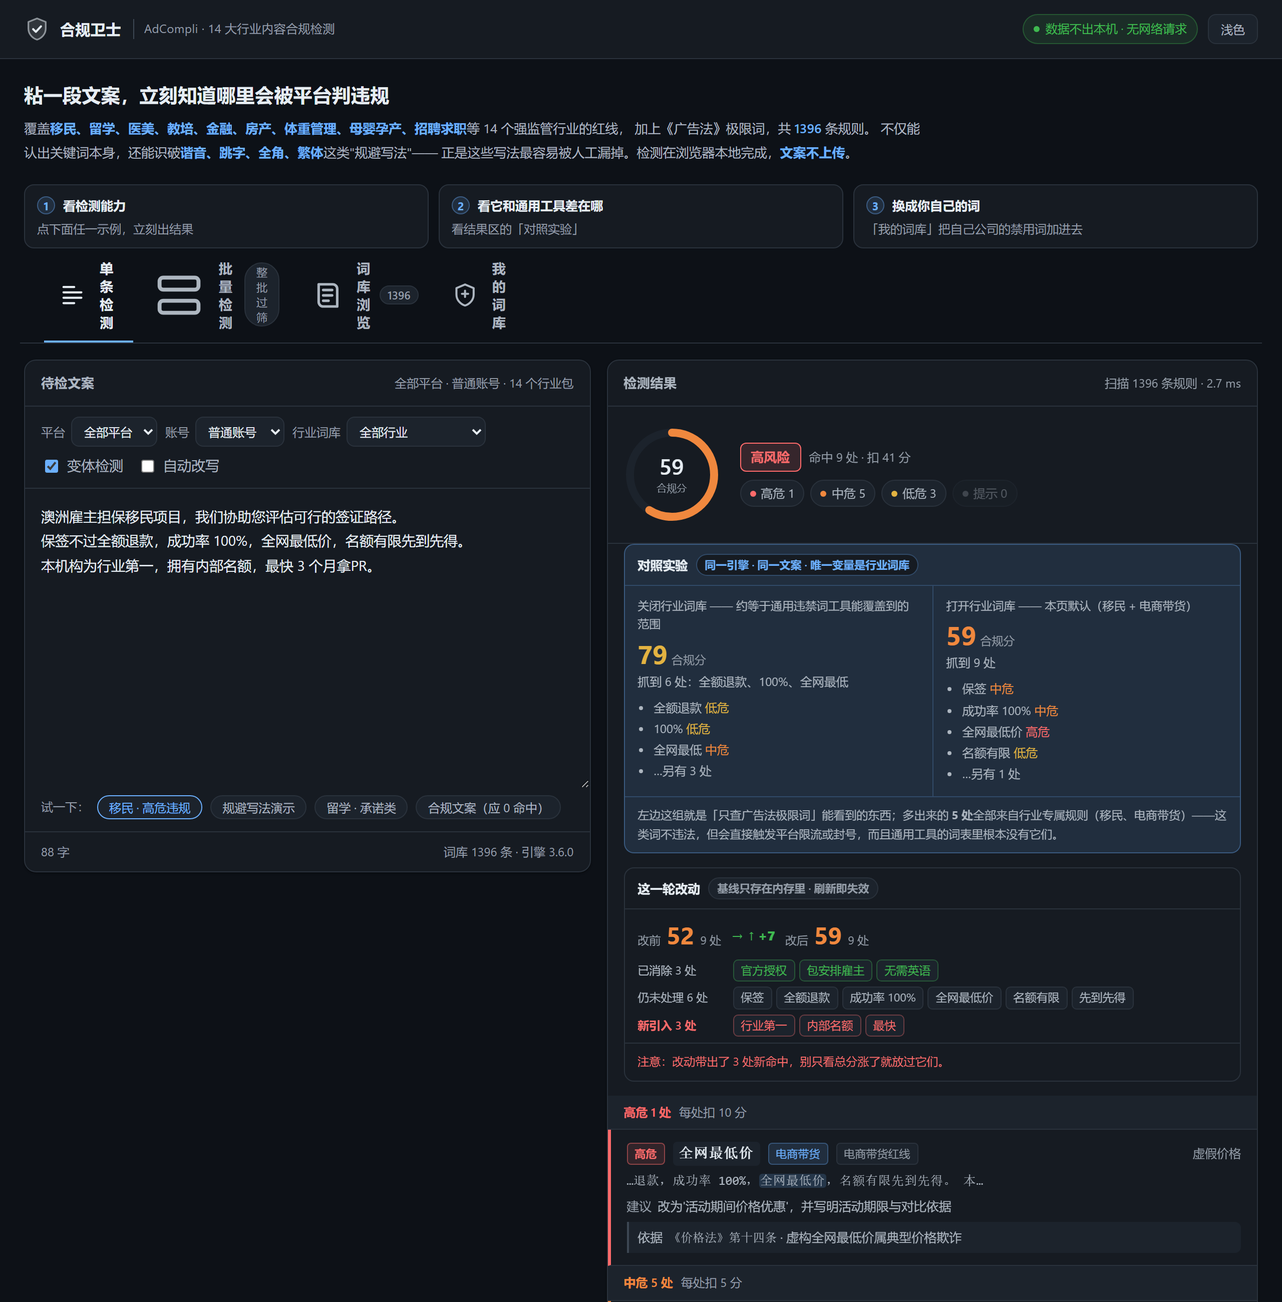
基线只存在内存里,刷新即失效,不落盘、不留原文。
我希望它能承担的是发布前的那一遍自查:把人工要来回核对的几个维度压缩成一次点击,再让人把注意力放在真正需要判断的地方——这句话该怎么说才既合规,又不丢掉想表达的东西。
毕竟,“我感觉应该没问题”和”我知道它为什么没问题”,中间隔着的就是这一遍。
项目地址:GitHub · 合规卫士 在线体验(零安装):https://qiaozt.pages.dev/guardian/
下一期想聊聊它的词库治理:一个规则驱动型工具,怎么让”该复核了”这件事从”靠人记得”变成”会红灯”——以及为什么我把第一批行业词库推翻重写过一次。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
